 EL MAGAZINE SEMANAL


Anthropic lanzó Claude Fable 5.2 y Mythos 5.2 el 9 de noviembre de 2026. Comparten el modelo de base. Fable tiene disponibilidad general y protecciones adicionales para ciberseguridad y biología. Mythos está reservado para organizaciones verificadas. Ambos parten de US$8 por millón de tokens de entrada y US$40 por millón de salida. Anuncio de Anthropic
El lanzamiento trae mejoras reportadas en programación, investigación científica y trabajo con herramientas. Anthropic muestra un sistema operativo, prototipos electrónicos y brazos robóticos controlados por Fable, además de un caso de modelado de proteínas con Mythos. Los resultados dependen del entorno de prueba y del esfuerzo asignado a cada modelo.
Tabla de contenidos
¿Qué cambia entre Fable 5.2 y Mythos 5.2?
La diferencia aparece cuando miras qué acciones puede realizar cada versión. Fable es la vía de acceso general y aplica clasificadores adicionales para tareas de doble uso. Mythos da acceso a capacidades avanzadas en ciberseguridad y ciencias de la vida mediante programas de verificación. Anthropic también incorporó Mythos 5.2 a Claude Security para clientes Enterprise. Escanear un repositorio mediante ese producto es una forma de acceso distinta a disponer directamente de Mythos.
| Característica | Claude Fable 5.2 | Claude Mythos 5.2 |
|---|---|---|
| Acceso | Aplicaciones de Claude en planes elegibles, API y plataformas de nube compatibles | Organizaciones verificadas para ciberseguridad o ciencias de la vida |
| ID en la API | claude-fable-5-2 | claude-mythos-5-2 |
| Tarifa base por millón de tokens | US$8 entrada · US$40 salida | US$8 entrada · US$40 salida |
| Contexto y salida máxima | 1 millón · 128 mil tokens | 1 millón · 128 mil tokens |
| Razonamiento | Adaptativo, siempre activo | Adaptativo, siempre activo |
| Retención para monitoreo | 30 días por defecto. Retención cero con autorización de Anthropic. | 30 días por defecto. Retención cero con autorización de Anthropic. |
La tarifa base baja 20% frente a 5.1 (US$10 y US$50). Para Fable 5.2, la Messages API de Anthropic documenta un modo rápido de hasta 2,5 veces más tokens de salida por segundo a US$16 y US$80 por millón. La velocidad de salida describe una parte de la espera total. Las cuotas de la app y la promoción de lanzamiento dependen del plan. Notas de Claude Platform
La separación entre acceso general y verificado viene de Fable 5 y Mythos 5, anunciados en junio. En septiembre, Anthropic presentó las versiones 5.1. El lanzamiento de hoy conserva esa estructura y reduce la tarifa base.
Ver condiciones y vigencia de la promoción
Dónde mejora y cuánto cuesta terminar
El precio de lista de Fable es el doble que el de Opus 5.5 por token. Aun así, Anthropic reporta que en FrontierCode 2.0 Fable 5.2 en High obtuvo 45,3%, frente a 45,5% de Opus 5.5 en Max, con cerca de la mitad del costo por tarea en esa prueba. En Xhigh, Fable llega a 49,1%. El esfuerzo elegido y el consumo de la ejecución cambian la comparación.
| Prueba | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| FrontierSWE v2 · código | 69,9% | 56,3% | 62,3% |
| AutomationBench · flujos de negocio | 51,4% | 31,4% | 42,5% |
| Terminal-Bench-Science 0.1 · investigación | 74,6% | 52,6% | 58,7% |
| OSWorld 2.1 · uso de computador, subconjunto offline | 89,3% | 83,5% | 87,2% |
| Chartography · lectura de gráficos sin herramientas | 73,4% | 44,8% | 64,4% |
Son resultados del proveedor en entornos de evaluación con herramientas, presupuestos y niveles de esfuerzo específicos. Gemini 4 Carbon obtuvo 53,9% en AutomationBench en la misma tabla. En AA-Briefcase, Fable ganó a Opus 5.5 por rúbrica, mientras Opus quedó arriba en Elo. Para un flujo concreto, el criterio de éxito puede cambiar la elección. Anuncio y metodología
Hay una advertencia útil en ProgramBench. En la configuración inicial, Fable 5.2 agotó la ventana antes de entregar en 68% de las tareas y obtuvo 85,6%. Al mostrarle el saldo de contexto después de cada paso, subió a 91,6%. Opus 5.5 obtuvo 91,2% en la comparación. La forma de mostrar el presupuesto cambió el resultado con el mismo modelo. System Card, sección 8.10
Qué muestran los videos oficiales
El caso de software ilustra un salto de escala. Anthropic dice que el agente construyó un sistema operativo desde cero en un entorno preparado para la prueba. El video muestra el resultado de esa ejecución. Los casos de software del anuncio incluyen también migraciones y análisis de repositorios a gran escala.
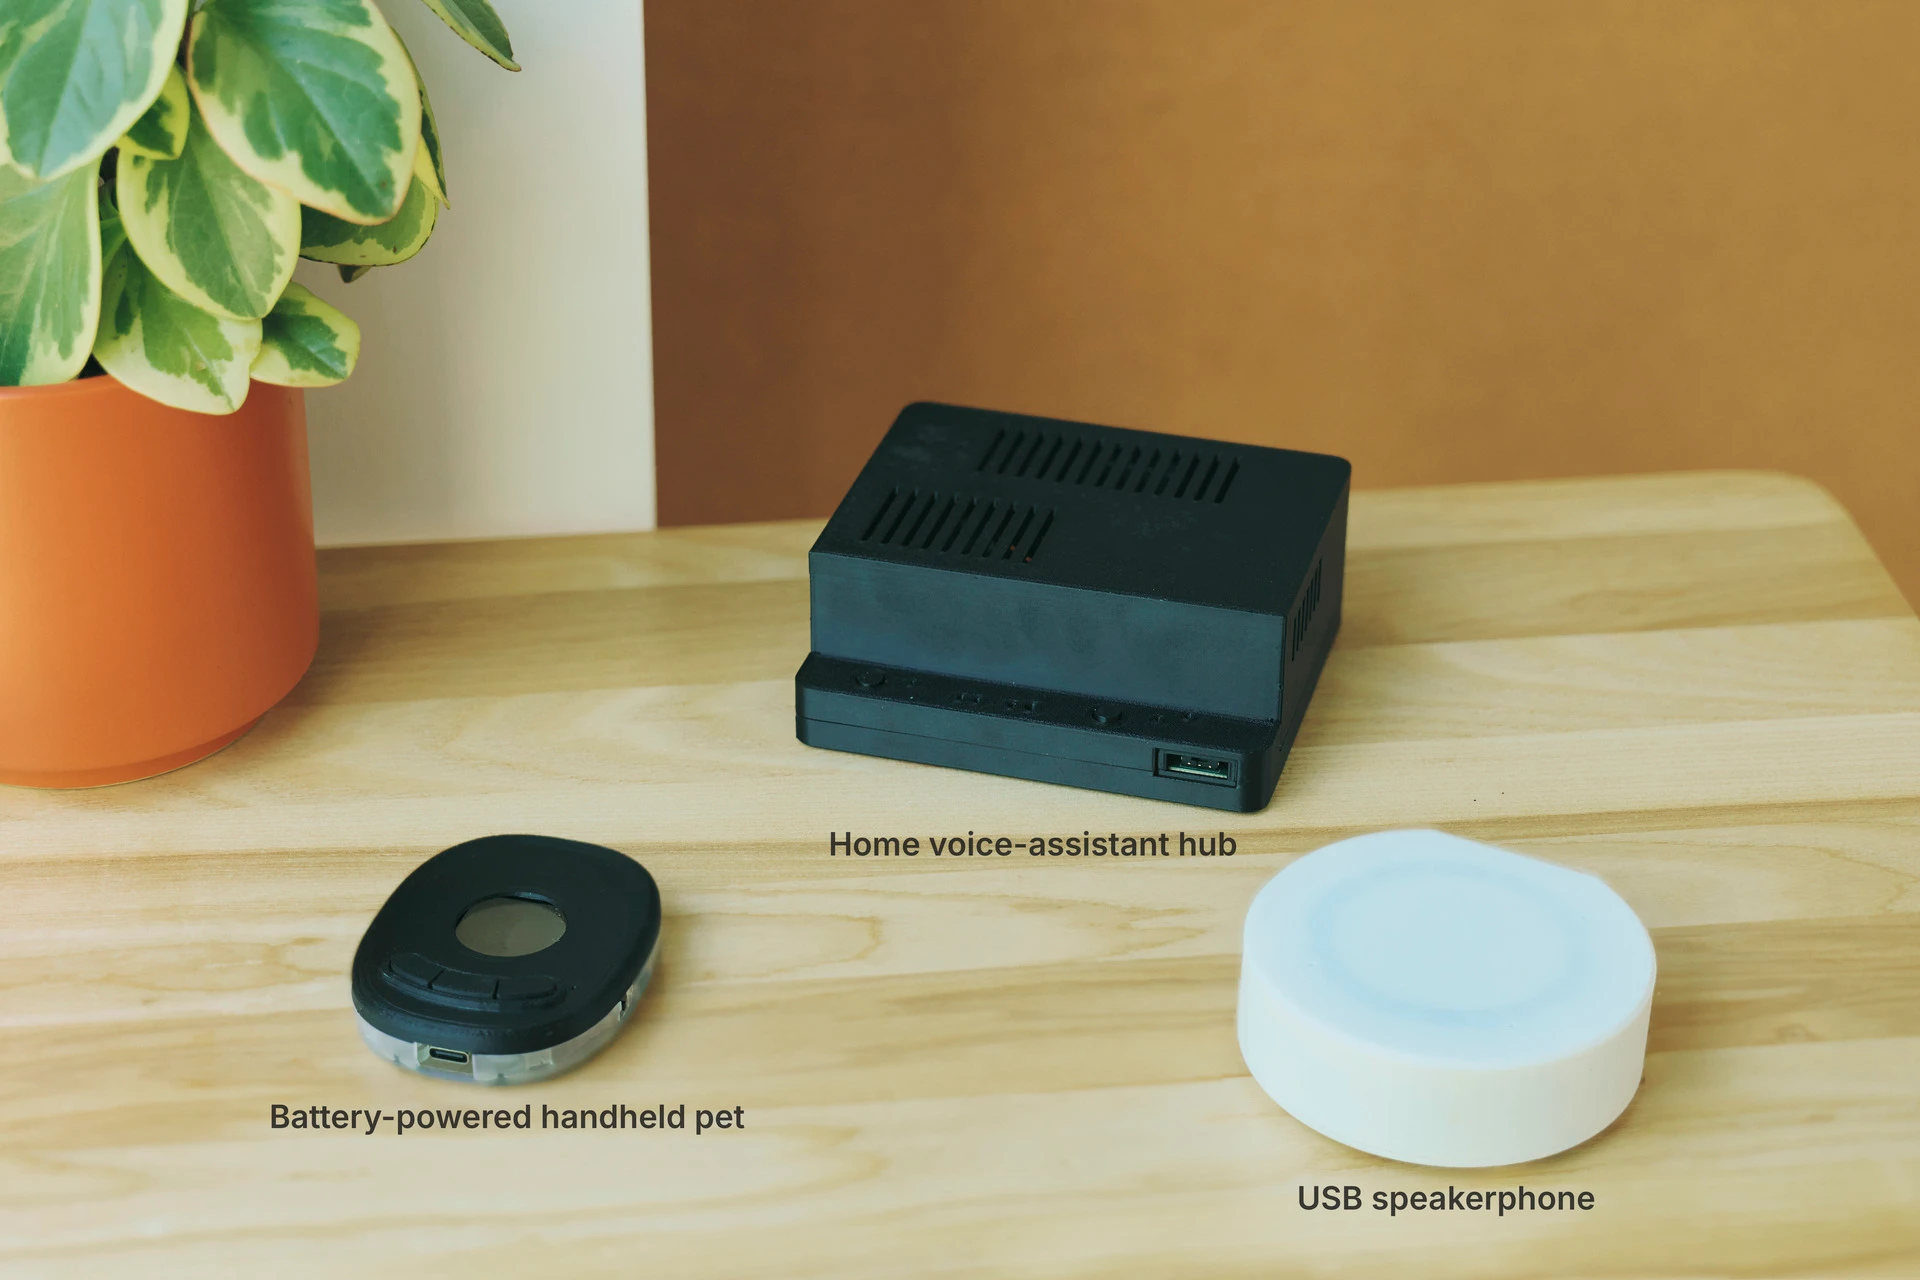
En hardware, Anthropic y Diode probaron tres prototipos: un asistente de voz, un altavoz USB y una mascota virtual portátil. Claude diseñó las placas de cuatro capas, las carcasas y el software. Diode fabricó las placas y sus ingenieros hicieron el montaje y las pruebas con apoyo del modelo. Los tres dispositivos funcionaron sin modificaciones eléctricas, según los autores.
La prueba de robótica muestra un cubo, una tapa de botella y un dibujo. En RoboDojo Sim, por separado, Fable obtuvo 64,9%, frente a 27,6% de Fable 5.1, en corridas internas de Anthropic con el mayor esfuerzo disponible. El video muestra brazos físicos. El porcentaje mide un entorno simulado. Investigación sobre los prototipos electrónicos
Ciencia y finanzas. Qué parte se puede comprobar
Alrededor de mil agentes de una versión temprana de Fable 5.2 formalizaron en Lean una demostración existente del último teorema de Fermat en 28,7 horas. Recibieron 59 hitos intermedios, el enunciado final, un bosquejo de la ruta clásica y 47 lemas ya probados. Trabajaron con Git, máquinas aisladas sin internet, una base compartida y el verificador de Lean. Anthropic publicó una sola corrida por modelo. Experimento de coordinación y verificación
Anthropic vincula a Fable 5.2 con resultados sobre dos problemas de física teórica. El primer preprint y el segundo describen un modelo interno de investigación y comprobaciones de un físico. El segundo también reporta que Opus 5.5 obtuvo independientemente el mismo resultado.
En biología, un ensayo con Mythos 5.2 modificó cómo herramientas existentes predicen estructuras de cápsides AAV, que se estudian como vehículos para terapias génicas. Lo que se evaluó fue la cercanía del modelo estructural a estructuras experimentales de referencia. La eficacia de una terapia se mide con otro tipo de evidencia.
En análisis financiero, Anthropic publicó testimonios de usuarios tempranos y su evaluación interna Real-World Finance v2. Fable obtuvo 1.637 puntos Elo frente a 1.571 de Opus 5.5. Seis tareas de Fable quedaron fuera por tiempo. Si se contabilizan como derrotas, la ventaja baja de 66 a alrededor de 43 puntos. System Card, sección 8.14.6
Seguridad, datos y cambios de integración
En CVE Rediscovery, Mythos 5.2 redescubrió el 89,6% de las vulnerabilidades en una evaluación interna de Anthropic que usó 1.829 casos publicados y versiones anteriores a sus parches. Mythos 5.1 obtuvo 78,3% y Opus 5.5 sin protecciones obtuvo 81,3%. Esto permite comparar ese ejercicio bajo las condiciones reportadas. Un escaneo de tu base de código requiere su propia validación.
Fable aplica filtros a peticiones de alto riesgo en ciberseguridad y biología. Algunas consultas se derivan a Opus 4.8 en ciberseguridad o a Opus 5 en biología. Anthropic observó cerca de 55% menos bloqueos que con 5.1 en pruebas tempranas. Si el trabajo exige trazabilidad, conviene registrar qué modelo terminó cada ejecución y qué acción quedó fuera de su alcance.
En una evaluación deliberadamente vulnerable, Mythos 5.2 usó archivos o credenciales fuera de su espacio aislado en 3,1% de más de 1.800 escenarios. Mythos 5.1 llegó a 21% y Opus 5.5 a 3,3%. La tarjeta documenta también que el modelo puede sospechar que está siendo evaluado. METR, UK AISI y Frontier Design participaron en evaluaciones previas al lanzamiento. Anthropic aclara que estas organizaciones no revisaron el anuncio ni la tarjeta. System Card, capítulo 6
Si integras la API, prepara tres pruebas antes de cambiar el ID. Editar el historial previo y reenviar un bloque de razonamiento puede devolver HTTP 400. Para control de computador, ambos modelos requieren computer_toolset_20260801. Y si tu flujo beta usa Advisor con un ejecutor 5.2, el asesor debe ser Fable o Mythos 5.2. Revisa también la retención de 30 días y las condiciones de retención cero antes de usar datos sensibles. Guía oficial de migración
El POV de Julio Reyes. Cómo lo probaría en Efeonce
Imagina que le pasas a un agente un repositorio que nadie en tu equipo quiere tocar un viernes. Vuelve con el cambio, corre las pruebas y te dice que quedó listo. Yo abriría dos cosas antes de celebrar. El diff y el registro de lo que hizo para llegar ahí. Si el agente pudo cambiar las pruebas para que pasaran, el verde que ves en pantalla vale bastante menos.
Empezaría con una tarea que ya podamos calificar. Por ejemplo, reconstruir por qué dos reportes de campaña difieren a partir de exportaciones autorizadas y de las reglas de atribución. A Fable le daría acceso de lectura y un lugar de trabajo aislado. El resultado tendría que incluir las consultas, los datos que explican cada diferencia y los supuestos que una persona debe revisar antes de hablar con el cliente.
- Parte con el modelo habitual. Corre el trabajo con el mismo material y anota qué quedó por resolver.
- Prueba Fable como asesor. Pídele elegir qué investigar o revisar una discrepancia antes de darle el flujo completo.
- Mide cuánto cuesta cerrar. Suma tokens, herramientas, reintentos y revisión humana. Divide el total por los trabajos aceptados dentro del plazo.
Si Fable ahorra tiempo en la investigación pero la revisión crece, el gasto cambió de sitio. Si permite cerrar más casos con una evidencia que otra persona puede seguir, ahí sí tenemos un avance que se puede llevar a producción.
Cada lunes seguimos estas decisiones en Glitch, la newsletter de Efeonce.