 EL MAGAZINE SEMANAL


El micrófono se abre… en modo Flash.
La primera imagen puede salir preciosa. El problema aparece cuando alguien pide cambiar el fondo, mantener el producto exactamente igual y mover un detalle que ya estaba aprobado. De pronto estás revisando otra vez la etiqueta, la cara y una mano que antes funcionaba. Una corrección pequeña acaba de convertirse en una revisión completa.
Esa es la parte del lanzamiento de Images 2.6 que me interesa mirar: cuánto control conserva un equipo cuando empieza a trabajar sobre una imagen. OpenAI lo anunció el 4 de noviembre de 2026, con más velocidad, nuevas opciones de edición y formatos que incluyen GIF y SVG. El anuncio oficial reúne ejemplos y testimonios de sus primeros usuarios.
Hay material para entusiasmarse y también para hacer preguntas bastante concretas. Vamos a revisar qué llegó, qué muestran las demostraciones y cómo evaluar si este lanzamiento sirve para producir una campaña, además de una buena imagen para compartir el día del anuncio.
Tabla de contenidos
- Qué llegó con Images 2.6
- La velocidad sirve cuando puedes seguir pensando
- Editar sin volver a negociar toda la imagen
- Lo pusimos a prueba: dos escenas y dos correcciones
- Calidad y complejidad: dos decisiones distintas
- GIF: el movimiento también necesita una intención
- SVG: recibir vectores abre otra etapa de trabajo
- Qué muestran las piezas con texto y producto
- Cuánto cuesta: empieza por separar tarifa y resultado
- Lo que falta comprobar antes de incorporarlo a una campaña
- Cómo probarlo con una tarea real
- El micrófono se cierra
Qué llegó con Images 2.6
Conviene ordenar los nombres desde el principio. Images 2.6 es el nombre del lanzamiento; en la API aparecen dos modelos. GPT Image 2.6 Flare se orienta a iterar rápido. GPT Image 2.6 Sunburst apunta al trabajo visual con mayor detalle. Ambos reciben texto e imágenes.
| Superficie | Qué puedes hacer | Qué revisar antes de usarla |
|---|---|---|
| ChatGPT | Crear y editar imágenes en una conversación | Plan, límites y funciones visibles en tu cuenta |
| Codex | Generar y editar imágenes dentro del trabajo con el agente | Herramientas y acceso disponibles en tu entorno |
| API: Flare | Integrar generación y edición orientadas a iteración rápida | Calidad, complejidad, latencia y consumo real |
| API: Sunburst | Integrar trabajo visual detallado y correcciones | Fidelidad de los elementos que necesitas conservar |
El Centro de Ayuda de OpenAI aclara una distinción importante: Images está disponible en todos los planes, pero las funciones no tienen necesariamente el mismo despliegue. La creación de GIF sigue llegando a ChatGPT. Images con thinking está disponible en Plus, Pro y Business; Enterprise y Edu figuran como próximos. Antes de prometer un flujo a tu equipo, comprueba la cuenta que lo va a ejecutar.
También hay continuidad. Images 2.5, presentado el 8 de septiembre, ya trabajaba la fidelidad, los bocetos y la consistencia durante varias ediciones. La historia de 2.6 no empieza desde cero: suma posibilidades sobre una dirección que OpenAI ya venía desarrollando.
La velocidad sirve cuando puedes seguir pensando
En su anuncio oficial, OpenAI declara que Images 2.6 genera imágenes un 50 % más rápido y que Flare puede entregar resultados desde seis segundos cuando la calidad está en low. Es una afirmación del proveedor bajo esas condiciones. No equivale a un tiempo garantizado para cualquier escena ni permite calcular cuánto tardará una campaña completa.
Comparación de latencia con anuncio de viajes. Reproducida a 8×: no interpretar como velocidad en tiempo real. Fuente: OpenAI.
La comparación oficial de velocidad está reproducida a 8×, según la descripción del anuncio. Sirve para observar la secuencia comparada; no para cronometrar una generación como si estuviéramos viendo tiempo real.
La velocidad puede cambiar la conversación creativa. Si una alternativa llega mientras el equipo todavía tiene presente la decisión que estaba discutiendo, es más fácil comparar una luz, un encuadre o una intención. Si llega mucho después, alguien tiene que reconstruir el contexto antes de opinar. Reducir esa espera tiene valor, aunque la pieza final tarde más.
Ahora bien, producir alternativas más rápido también puede llenar la mesa de versiones que nadie tiene tiempo de revisar. Una exploración necesita una pregunta: decidir entre una escena íntima y una abierta, probar dos jerarquías o encontrar un fondo que permita leer el titular. Pedir veinte opciones sin saber qué estamos comparando sólo acelera la indecisión.
Por eso separaría dos mediciones. Una registra cuánto demora el modelo en devolver una imagen. La otra registra cuánto demora el equipo en aceptar una dirección y llegar a un archivo utilizable. El lanzamiento habla directamente de la primera; el trabajo de cada organización tendrá que demostrar qué pasa con la segunda.
Editar sin volver a negociar toda la imagen
Imagina una pieza de producto que ya tiene aprobado el encuadre. Falta cambiar el color de un elemento secundario. El pedido parece sencillo, pero el resultado sólo sirve si la forma del envase, las proporciones y el resto de la escena siguen siendo los que aprobaste.
La edición por anotaciones ayuda a expresar dónde está el cambio. El changelog de la API del 4 de noviembre confirma el soporte de image markup para los modelos compatibles 2.5 y 2.6. La referencia de edición describe una capa PNG transparente, del mismo tamaño que la primera imagen, sobre la cual se dibujan las indicaciones.
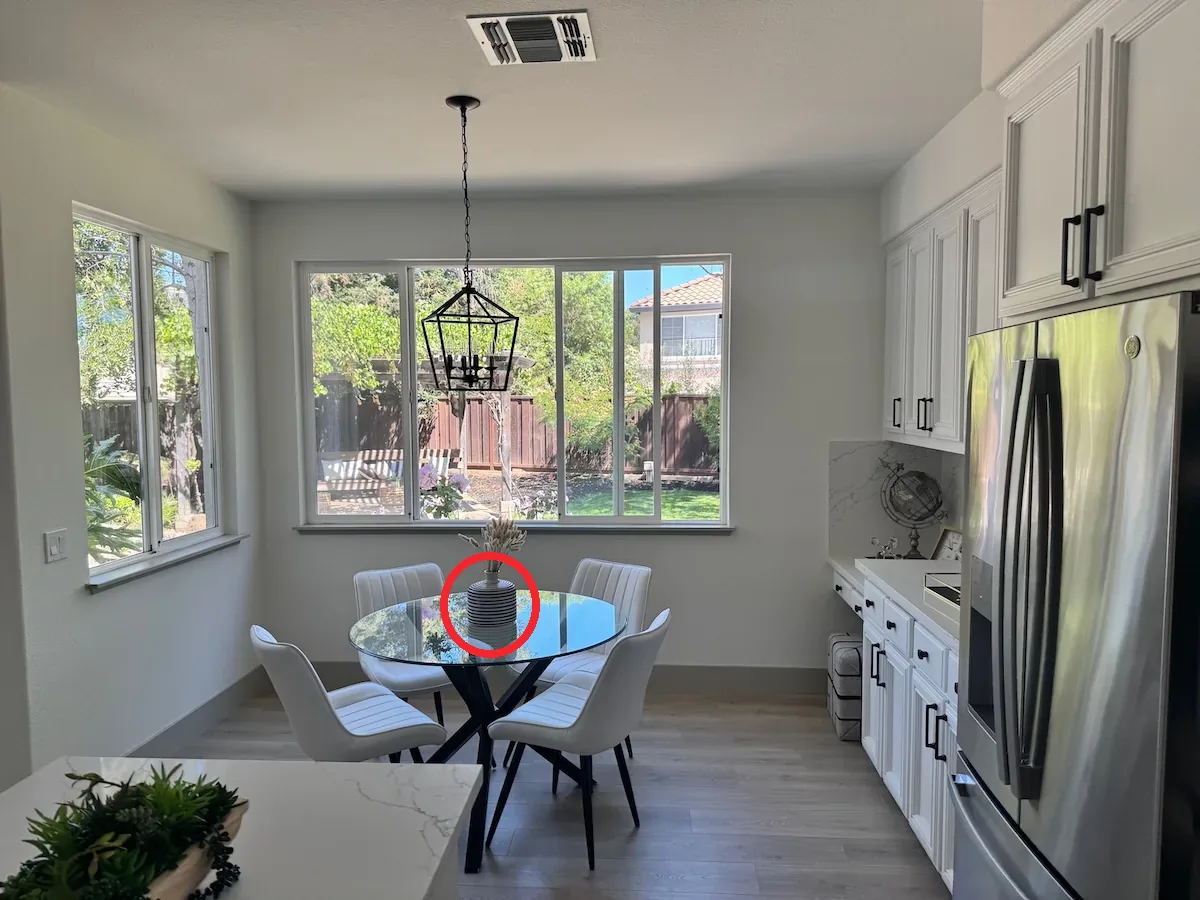
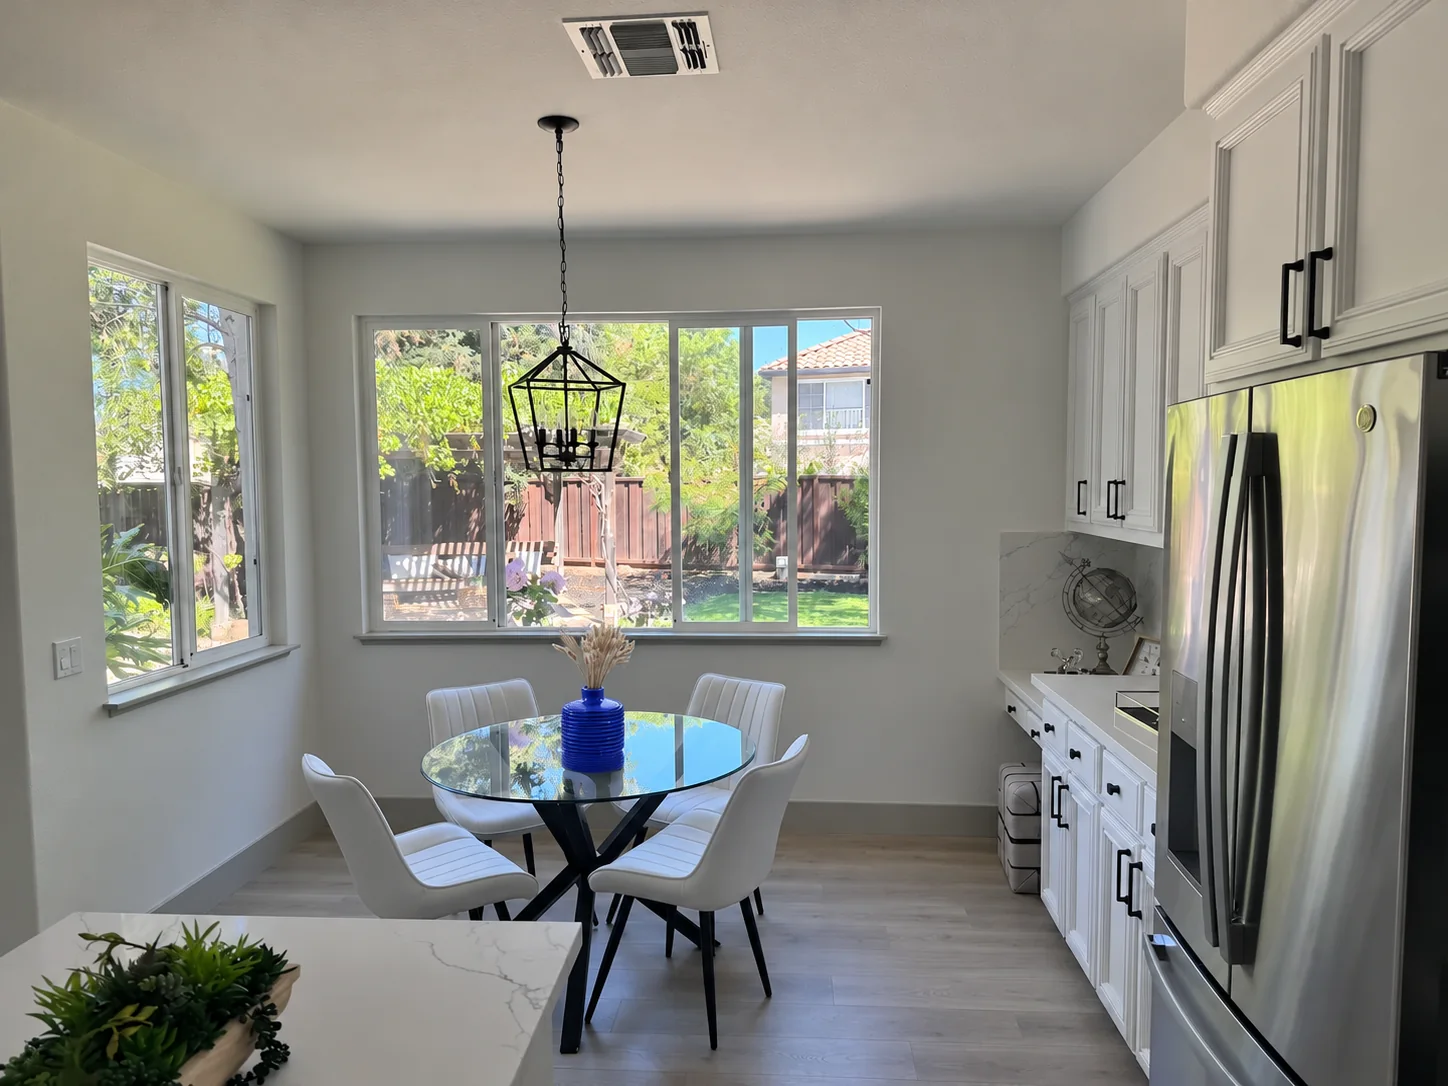
En el ejemplo de la guía de prompts de OpenAI, una marca roja identifica un florero y la salida lo muestra azul. Mira también la mesa, las sillas y los objetos cercanos. La utilidad de una corrección localizada se juega tanto en el objeto que cambia como en todo aquello que debía quedarse quieto.
Una demostración seleccionada no nos dice qué porcentaje de intentos conserva bien una escena. Sí permite formular una prueba mejor que «haz algo parecido»: partir de la misma imagen, pedir una modificación delimitada y revisar una lista explícita de elementos que deben permanecer. Después repetir el ejercicio con una segunda corrección. Ahí empieza a aparecer la diferencia entre una imagen atractiva y un proceso confiable.
Para una marca, ese perímetro puede incluir la geometría de un producto, un personaje, el vestuario, una textura o el espacio reservado para el copy. Escríbelo antes de generar. Si la condición sólo existe en la cabeza de quien aprueba, cada nueva versión vuelve a abrir la misma conversación.
Lo pusimos a prueba: dos escenas y dos correcciones
Hasta aquí, las demostraciones del lanzamiento. También quisimos llevar la pregunta de este Flash a una prueba propia: ¿qué pasa cuando una imagen tiene que soportar una segunda corrección?
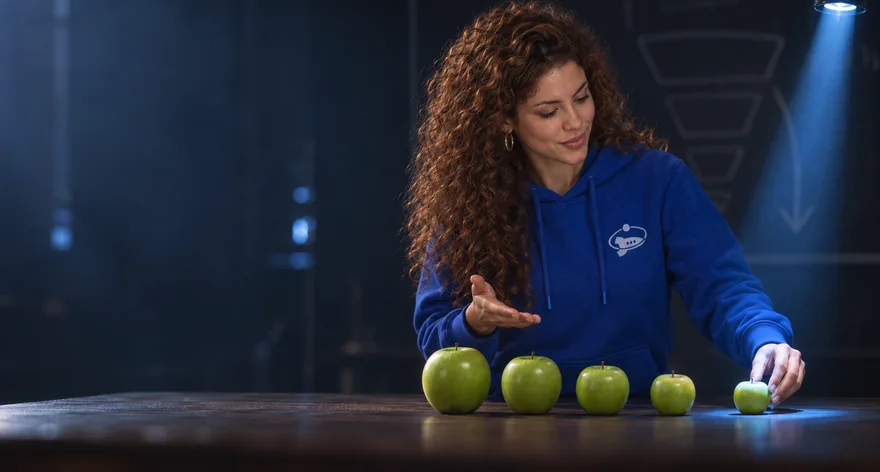
Trabajamos con Nexa, nuestro personaje de marca, y referencias visuales de su identidad, vestuario y accesorios. Generamos dos escenas originales con GPT Image 2.6 Sunburst, en 2048 × 1152 píxeles, con calidad y complejidad altas. Las dos comparten un universo cinematográfico: un hangar oscuro, imágenes en circulación y los Sparks como compañeros de escena. Es una ficción visual de Efeonce, no la representación de un acontecimiento real.
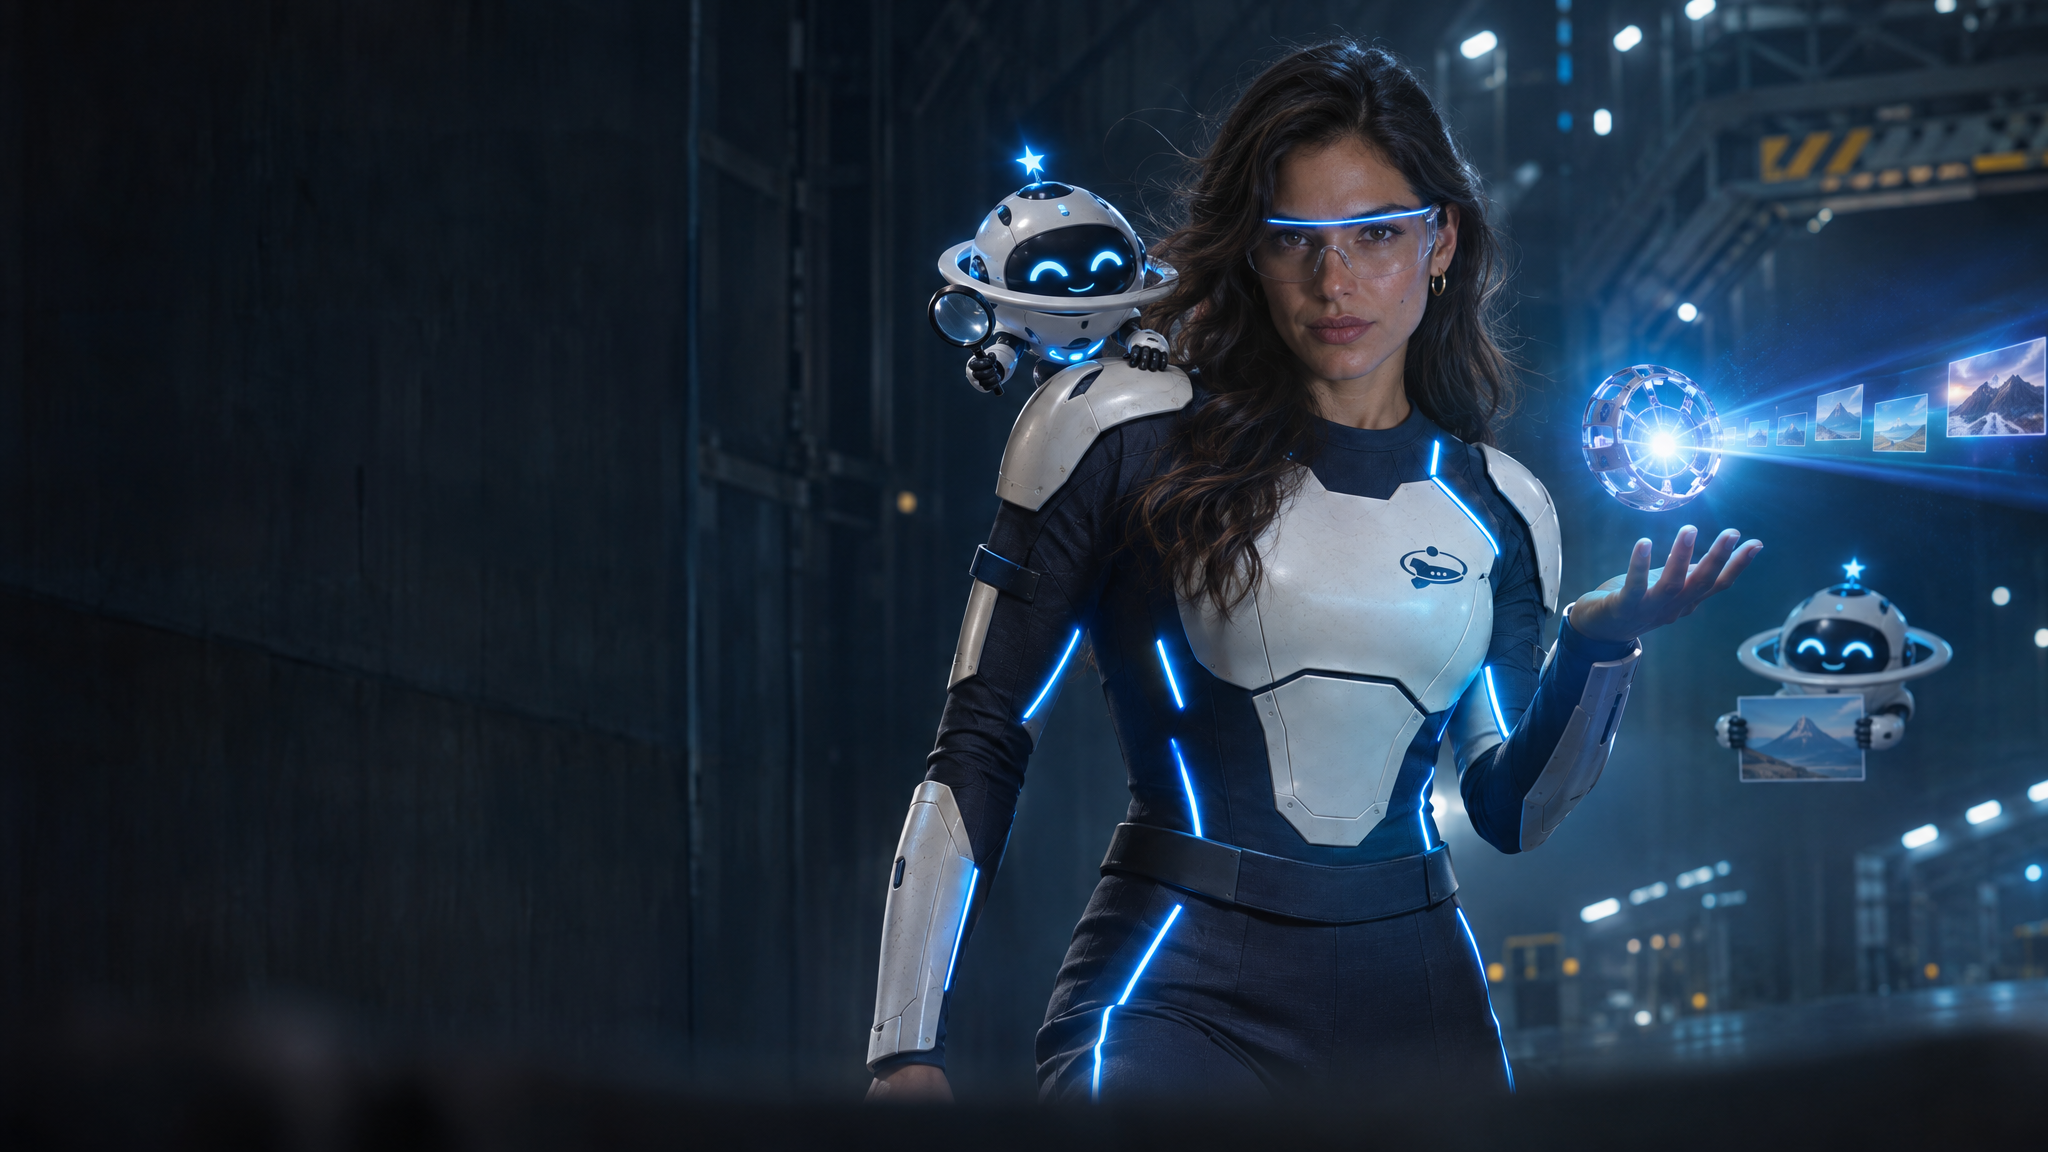
La primera escena coloca a Nexa frente a una corriente de imágenes. La segunda pide una acción más concreta: sostener un marco con un paisaje de montaña. Son dos generaciones distintas; la segunda no es una corrección de la primera. Esa distinción importa para leer lo que viene.
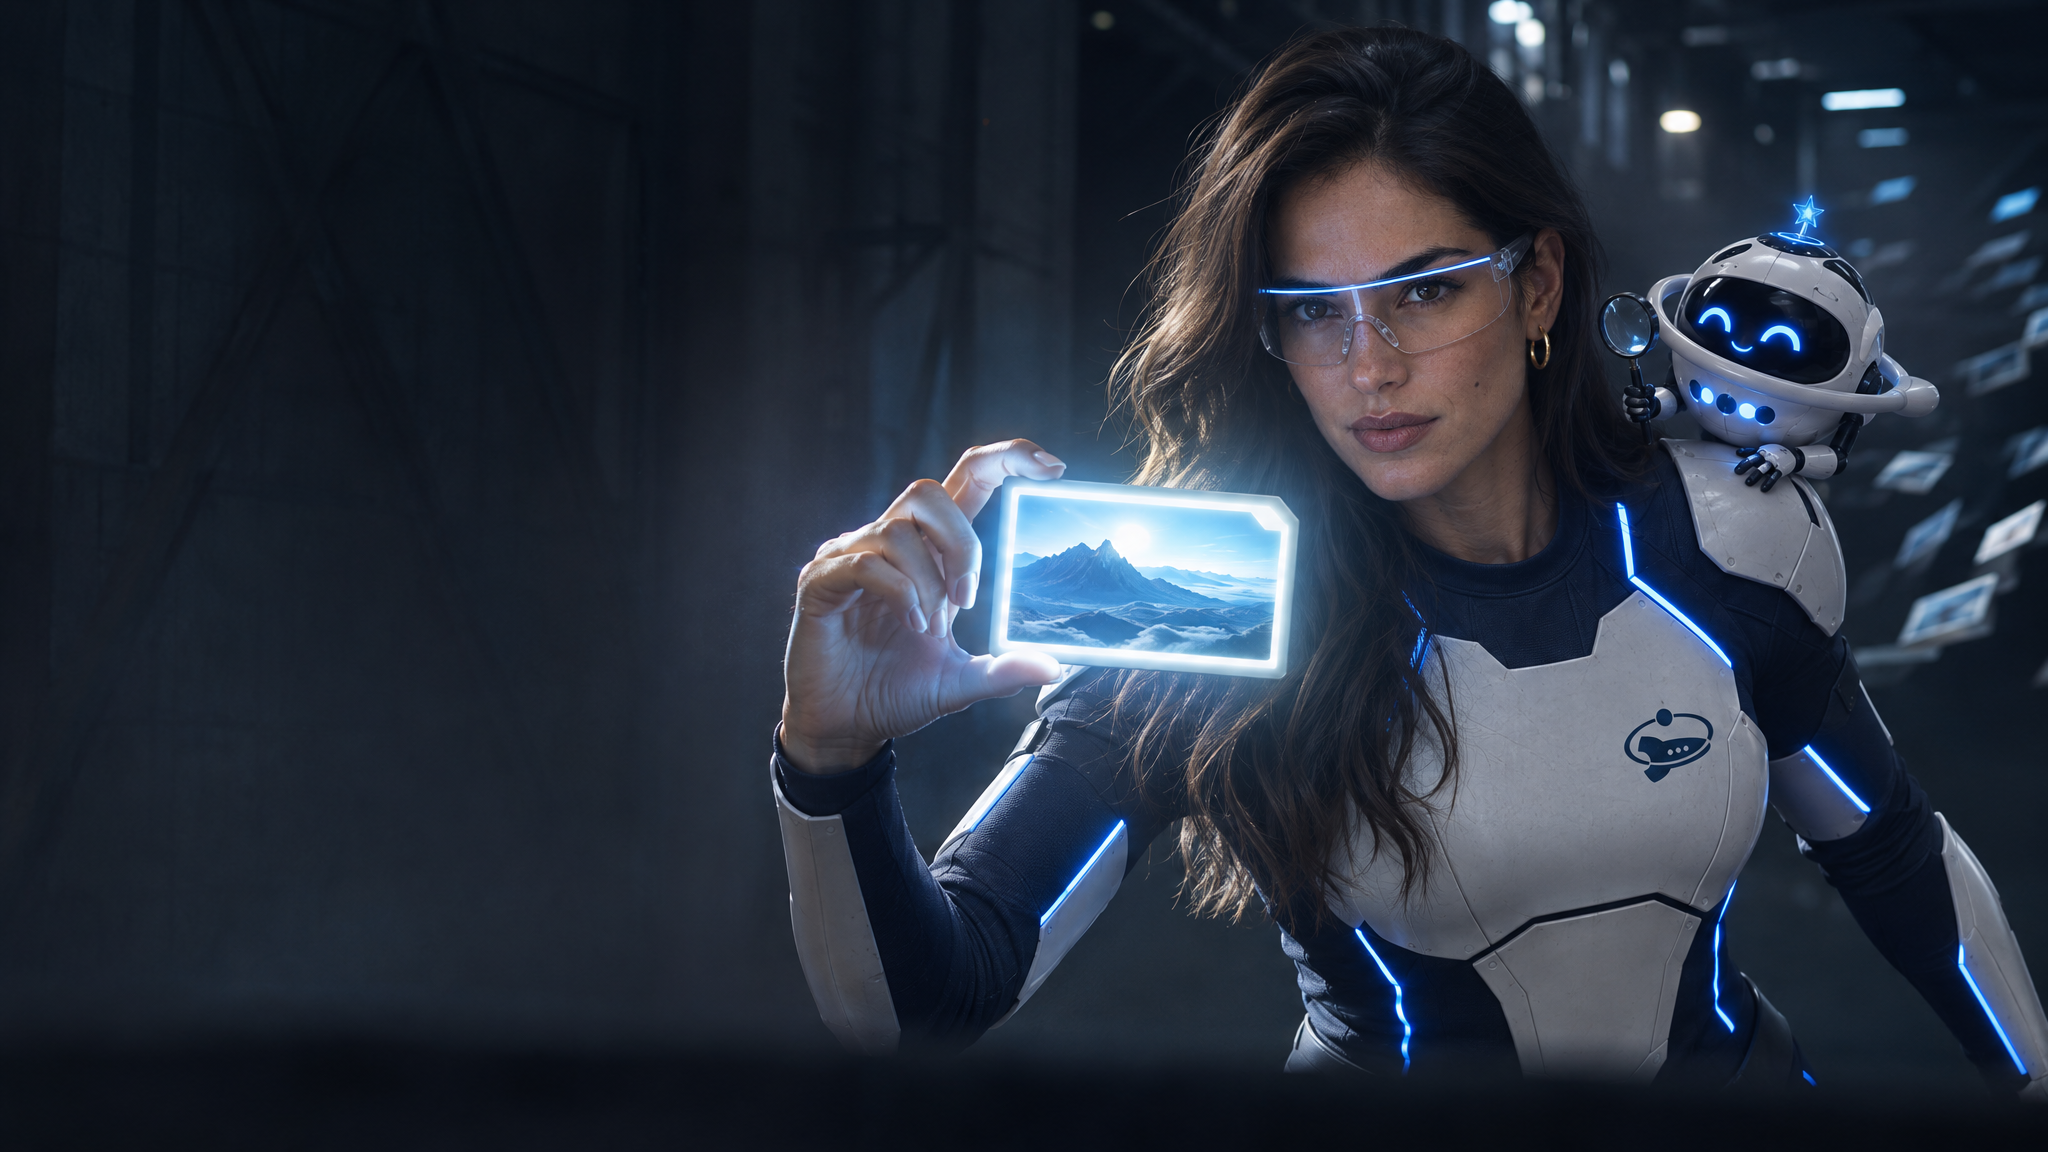
Sobre la segunda imagen hicimos una secuencia de dos ediciones. Primero señalamos el marco con una anotación y pedimos cambiar únicamente su borde pálido por uno naranja mate, conservando la montaña. Después usamos esa salida como entrada de la siguiente operación: reemplazar el paisaje interior por una selva con cascada, manteniendo el borde naranja y el resto de la escena.
La indicación se envió como una capa transparente mediante la función nativa de anotaciones. Las cuatro imágenes se muestran tal como las devolvió el modelo, sin retoque, recomposición ni una máscara que pegara el cambio sobre el original.
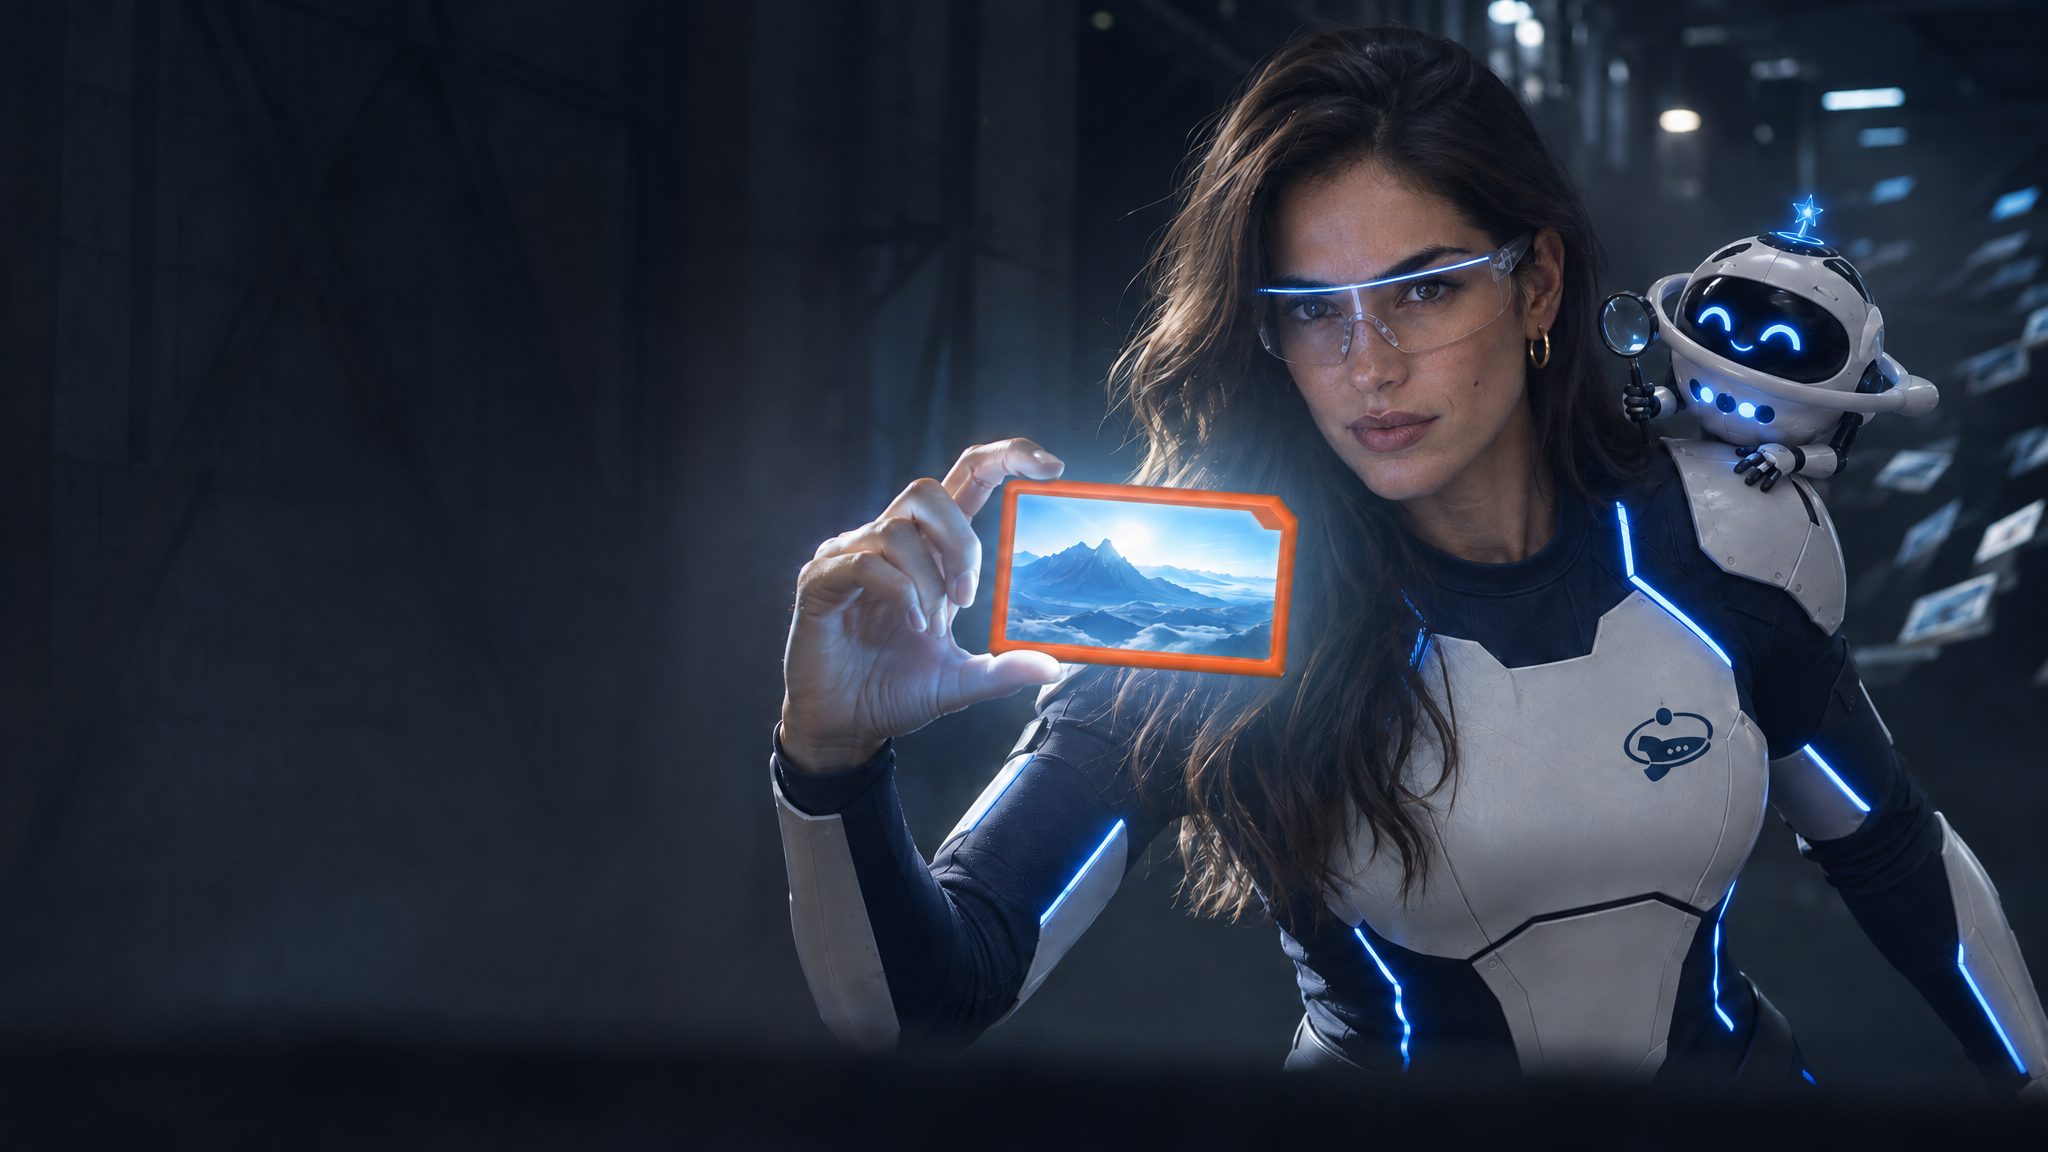
En la primera edición el borde pasa a naranja y la montaña permanece. También se reduce el aspecto luminoso del borde. En la segunda aparece la selva con cascada y se conserva el naranja. Al comparar las tres versiones de esta secuencia, el rostro, los lentes, la mano, el compañero y la perspectiva mantienen una continuidad visual reconocible.
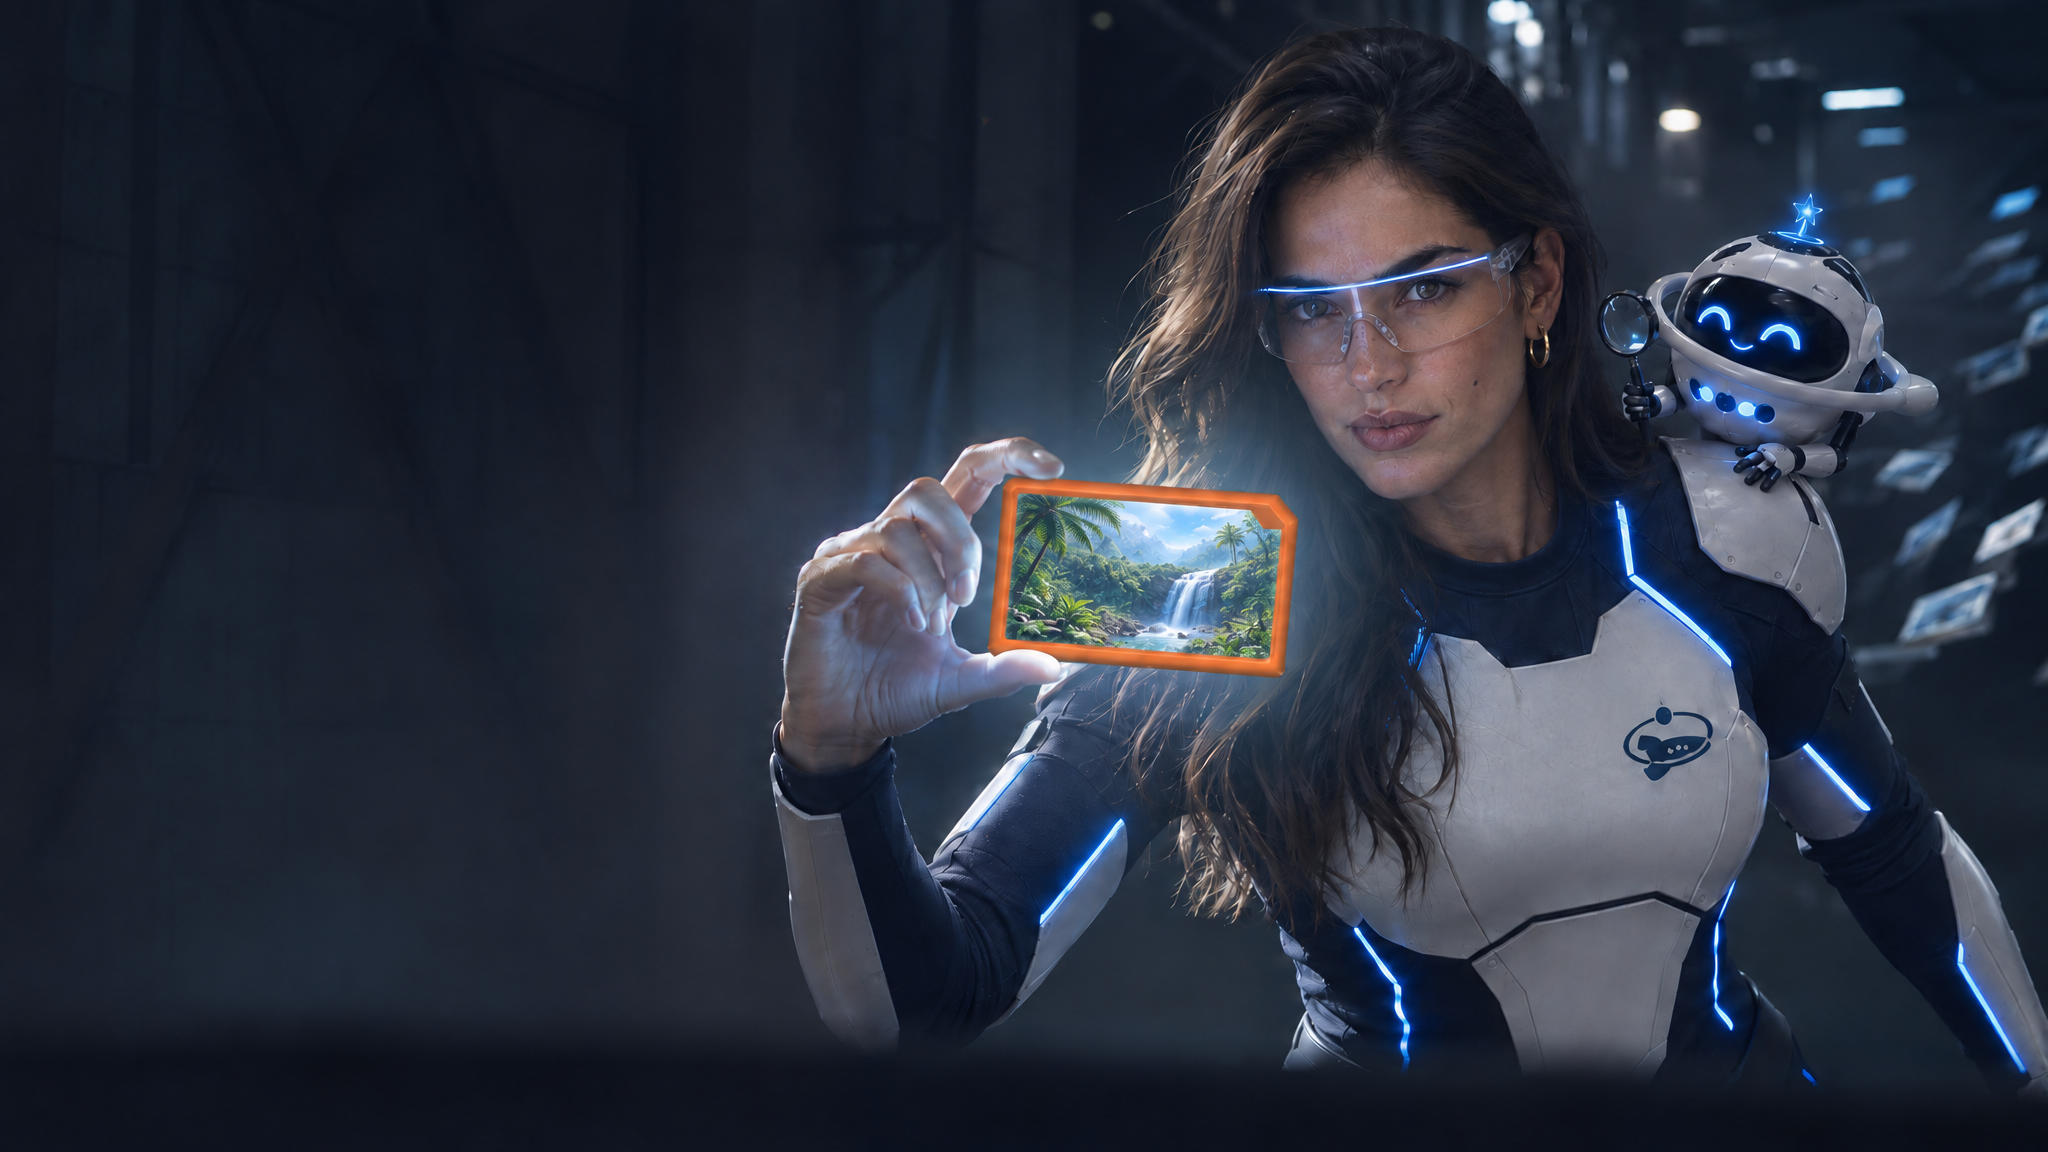
Ahí está el resultado que nos interesaba observar: pudimos encadenar dos pedidos distintos sobre la misma imagen y reconocer el trabajo anterior en la salida siguiente. Eso no significa que los píxeles fuera del área señalada hayan quedado intactos: encontramos variaciones fuera de ella. La anotación orientó la edición, pero la imagen completa siguió necesitando revisión.
La salida inicial tampoco cumplió todo el encargo: el borde brillaba aunque se había pedido cerámica mate, y el encuadre de la segunda escena quedó más cerrado de lo solicitado. La continuidad de las ediciones también conserva decisiones y desvíos de la imagen de partida. Estas cuatro salidas permiten examinar un caso; no establecen una tasa de acierto.
También registramos tiempos y consumo. Todos los resultados corresponden a Sunburst con calidad alta; para las ediciones bajamos la complejidad a low.
| Operación | Complejidad | Tiempo total | Tokens entrada / salida |
|---|---|---|---|
| Escena original A | Alta | 57,5 s | 14.347 / 1.413 |
| Escena original B | Alta | 55,2 s | 13.065 / 1.413 |
| Edición 1: borde naranja | Baja | 30,8 s | 1.859 / 1.413 |
| Edición 2: selva y cascada | Baja | 28,7 s | 1.868 / 1.413 |
Los tiempos miden la ejecución completa de nuestra herramienta: incluyen preparación, autenticación, subida, procesamiento y guardado. No son la latencia del proveedor ni un benchmark. Las generaciones originales recibieron varias referencias; cada edición recibió la imagen anterior y su anotación. Cambiaron las entradas y la tarea, así que estos números describen esta secuencia, sin aislar el efecto de la complejidad ni comparar modelos.
Calidad y complejidad: dos decisiones distintas
El nuevo control de complejidad merece una pausa porque invita a un error conocido: subir todos los parámetros y esperar que eso resuelva el brief.
La referencia de generación distingue complexity de quality. El primero regula el esfuerzo de planificación; el segundo, la calidad visual de salida. La guía de generación recomienda probar complejidad baja para muchas ediciones y reservar niveles mayores para solicitudes con más elementos o restricciones.
Pensemos en dos pedidos hipotéticos. En uno cambias el color de una taza. En el otro compones una mesa con varias personas, productos identificables, un gesto particular y espacio para un titular. Los dos pueden necesitar una imagen final cuidada, pero el problema de relaciones entre elementos es muy distinto.
Esa separación abre una forma más precisa de experimentar. Mantén la calidad que exige el uso final y cambia la complejidad para observar si mejora el cumplimiento del pedido. Después compara el tiempo y las alteraciones que introduce. El ajuste útil será el que resuelva ese trabajo con menos fricción; no hay una combinación universal para todas las marcas, escenas y correcciones.
En un flujo compartido, registra también la configuración. Una persona del equipo debería poder entender cómo se obtuvo una versión aceptada sin reconstruir una tarde completa de pruebas. El prompt ayuda, pero una captura aislada del prompt no guarda por sí sola las referencias, las decisiones y los parámetros que hicieron funcionar el resultado.
La siguiente versión también debe conservar lo que ya decidiste
GIF: el movimiento también necesita una intención
Las animaciones breves son una de las novedades más visibles. El anuncio muestra ejemplos de OpenArt y Town: personajes, reacciones y pequeñas escenas que exploran movimiento. Son demostraciones del lanzamiento, seleccionadas por el proveedor y sus colaboradores; no evaluaciones independientes de una campaña.
Montaje oficial de escenas animadas generadas con Images 2.6. Fuente: OpenAI.
La documentación oficial añade este ejemplo de un personaje con una linterna. Sirve para mirar un loop con una tarea concreta: seguir el gesto, observar qué partes del personaje permanecen y revisar la transición entre el final y el principio.
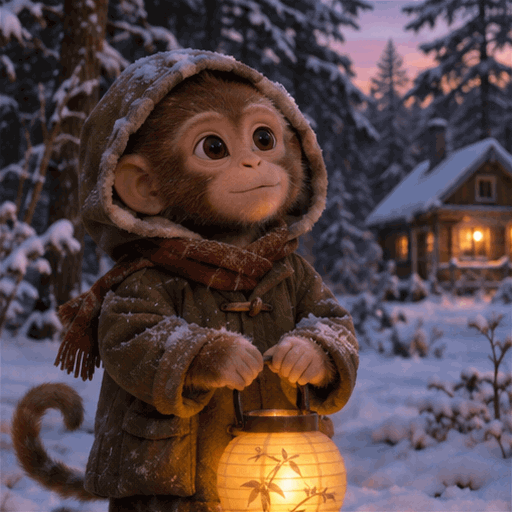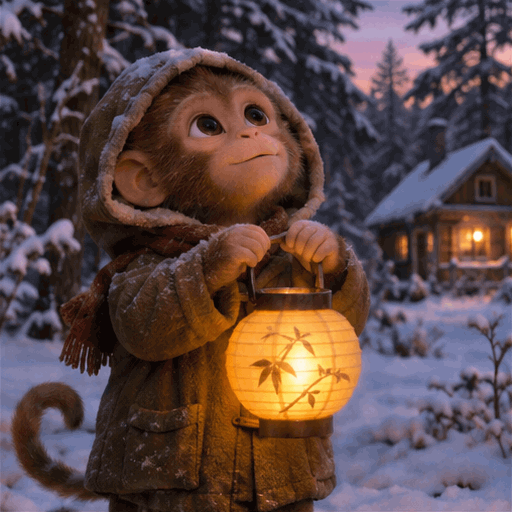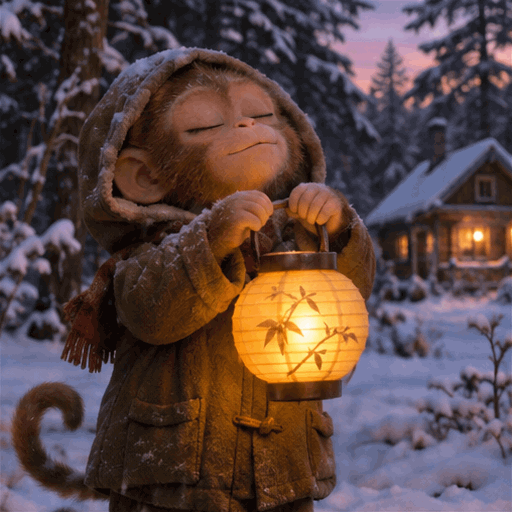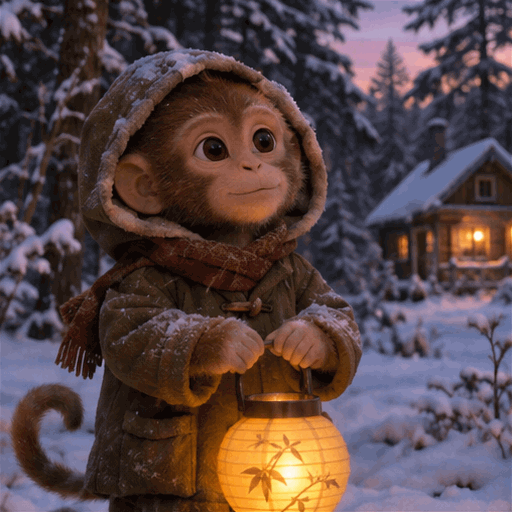
Un GIF puede resolver una reacción, una señal de estado o el pequeño gesto de una mascota. La pregunta creativa viene antes del movimiento: ¿qué debe comunicar ese gesto que una imagen fija no comunica igual? Si no hay respuesta, probablemente sólo estamos agregando actividad a la pieza.
Para una marca, revisaría especialmente que el personaje siga siendo reconocible en cada cuadro y que el loop tenga una vuelta natural. Una deformación apenas perceptible en una reproducción puede volverse evidente después de verla repetirse diez veces. También importan el peso del archivo, el tamaño de visualización y el formato que acepte el canal.
Esto no convierte a los modelos en un sistema de producción audiovisual completo. Un GIF no trae por sí solo sonido, montaje ni control narrativo de una secuencia larga. Si el destino requiere MP4, habrá otra etapa de preparación. Y si se usa en una interfaz, hay que decidir cuándo se mueve, cuándo se detiene y cómo se comporta para quien prefiere menos animación.
Al revisar las fuentes el 5 de noviembre, la guía de generación admite hasta 64 cuadros por GIF y la referencia de generación indica hasta 16. Esa discrepancia entre páginas oficiales impide dar aquí un máximo como condición cerrada. Antes de comprometer una animación, comprueba la operación, el acceso y el archivo real en la cuenta con la que vas a trabajar.
SVG: recibir vectores abre otra etapa de trabajo
La salida SVG en la API puede ser especialmente útil para equipos que necesitan gráficos escalables. La referencia de generación describe un flujo con una imagen de referencia y un modelo autor que produce el SVG. Eso explica por qué conviene mirar tanto el resultado visual como la estructura del archivo, y por qué su costo puede tener más de un componente.
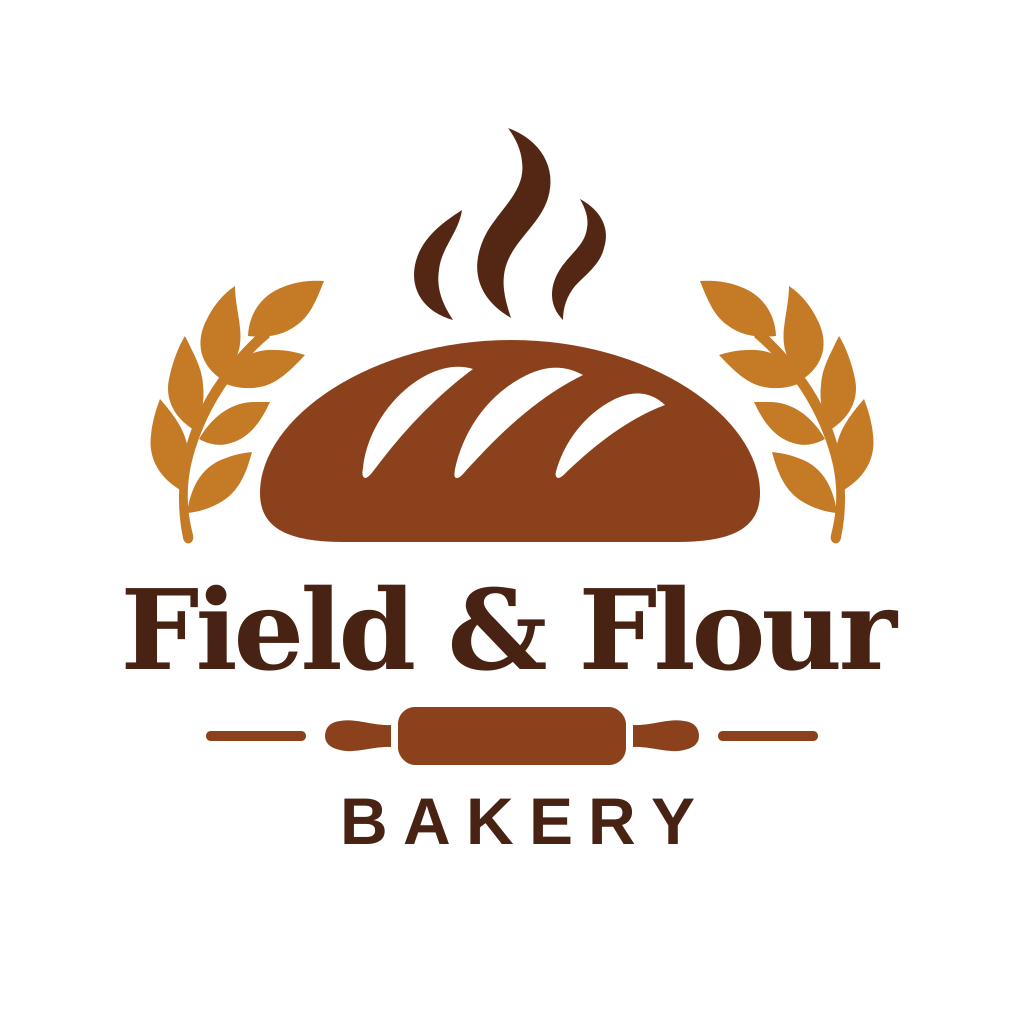
El ejemplo oficial de Field & Flour permite revisar una composición con ilustración y lettering. Que un archivo se pueda ampliar no resuelve automáticamente su espaciado, la coherencia del trazo o su funcionamiento en tamaños pequeños. Un vector también puede dibujar una decisión equivocada con una nitidez impecable.
Yo lo evaluaría en tres usos reales: el tamaño al que se va a leer, una reducción exigente y una ampliación donde aparezcan los detalles del trazado. Después comprobaría si el equipo puede editarlo de forma razonable. Un archivo que exige rehacer casi todo para cambiar una palabra tiene un valor distinto al de uno que permite continuar el trabajo.
Para un logo o un sistema de iconos, además hay decisiones de identidad que no se delegan a la extensión del archivo. Hay que revisar formas, jerarquía, consistencia con el sistema y usos previstos. En impresión también corresponde verificar el proceso de salida. El SVG puede ser un material de trabajo valioso; su aprobación sigue dependiendo del uso.
Qué muestran las piezas con texto y producto
Los ejemplos oficiales de la guía también incluyen una infografía de una cafetera en español y una escena publicitaria de producto. Son útiles para mirar asuntos más exigentes que el acabado general: legibilidad, relaciones entre partes y reconocimiento del objeto.
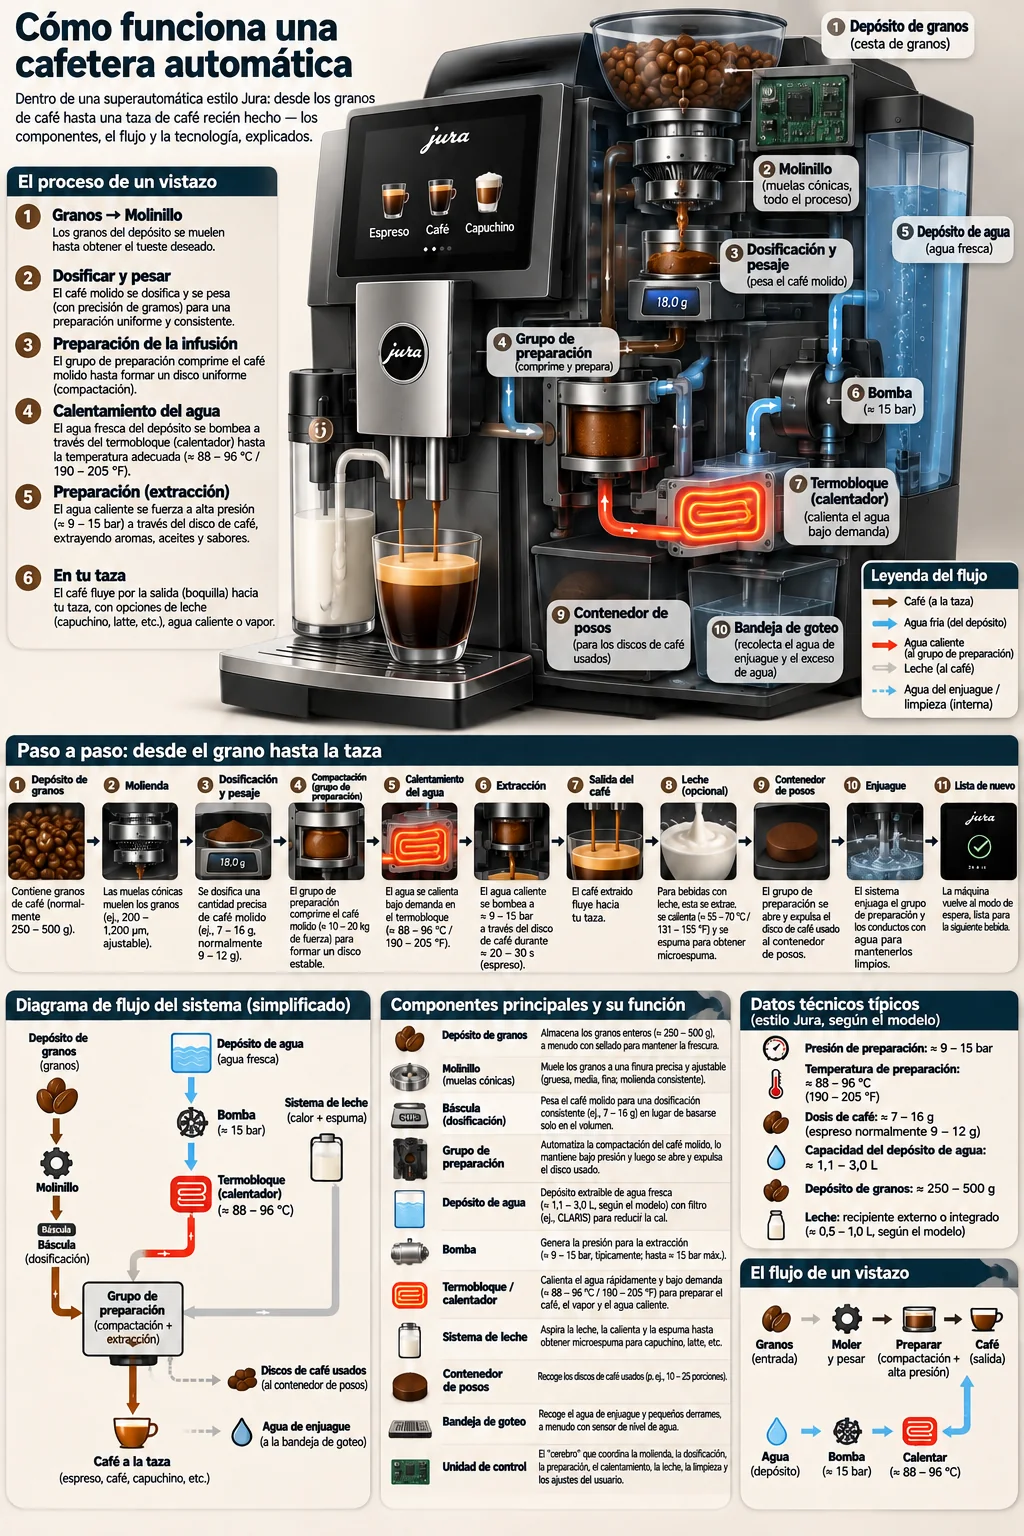
En una infografía, revisa cada etiqueta y el vínculo entre el texto y la pieza que pretende explicar. Luego reduce la imagen al ancho de un teléfono. La información tiene que seguir siendo comprensible ahí. Una demostración de texto dentro de una imagen tampoco verifica que las afirmaciones técnicas del diagrama sean correctas.
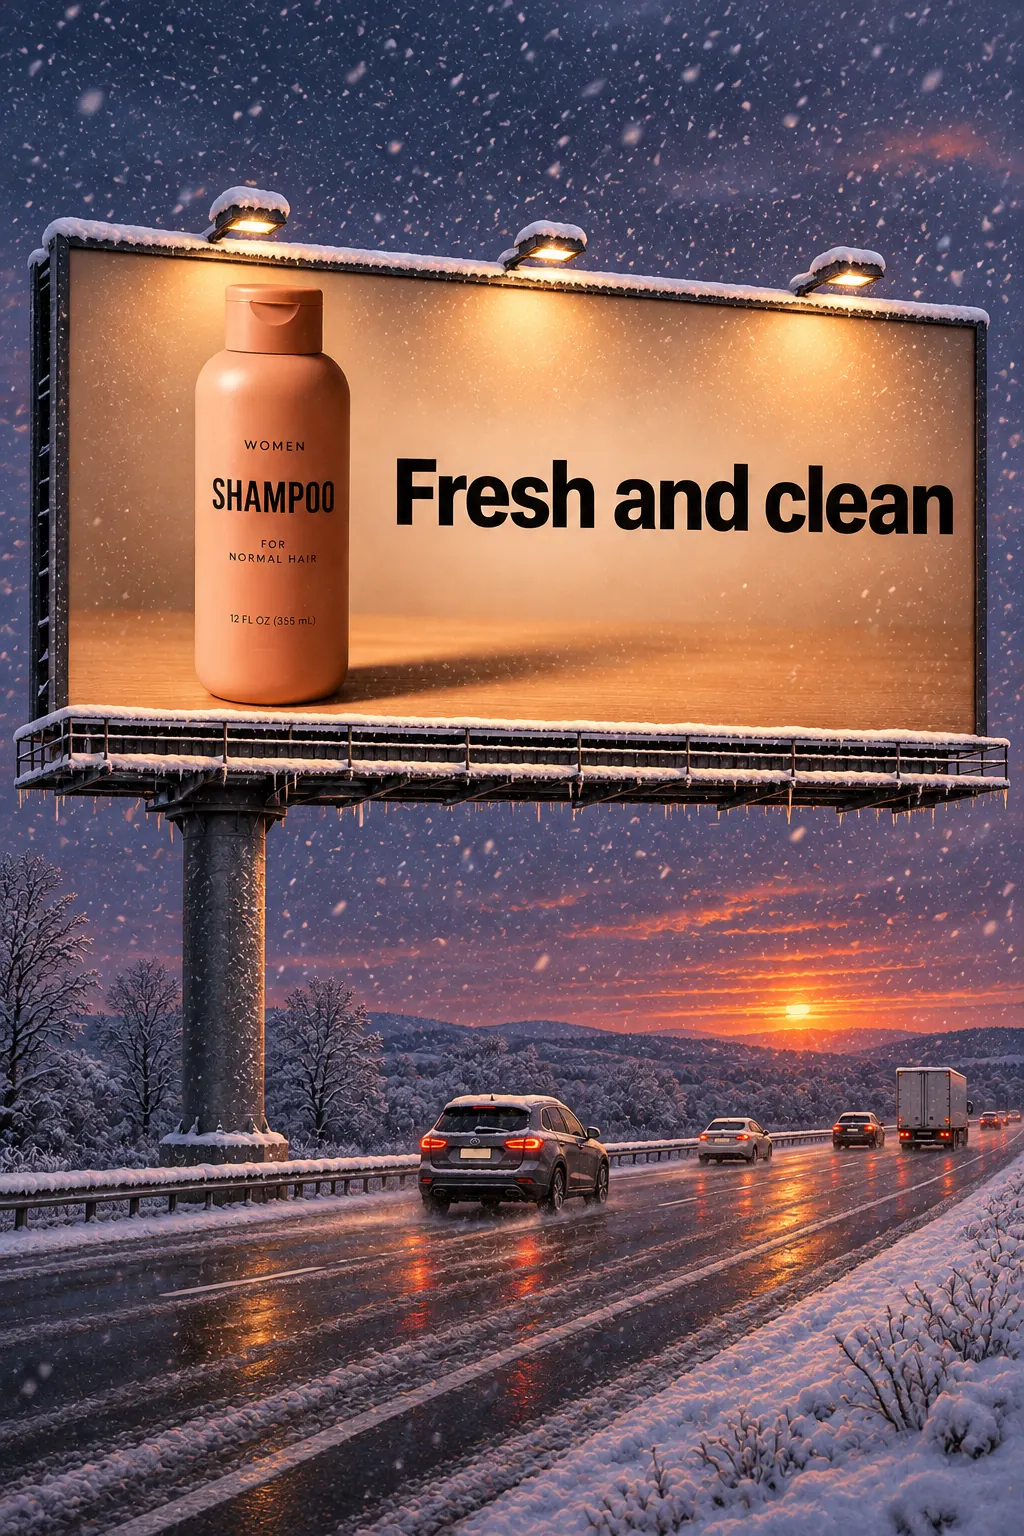
En una escena publicitaria, observa el producto, la escala y lo que ocurre alrededor del envase. Una imagen puede resultar convincente como conjunto y contener un detalle incompatible con el producto real. Esa diferencia importa mucho si la pieza se va a usar para venderlo.
Puedes contrastar ambos ejemplos y sus instrucciones completas en la guía oficial de prompts de OpenAI. Si te interesa aplicarlos a tu marca, conserva esa relación entre el pedido y el resultado: es lo que permite entender qué estás evaluando.
Cuánto cuesta: empieza por separar tarifa y resultado
Las tarifas Standard publicadas para Flare y Sunburst coinciden. Estos son los valores consultados el 5 de noviembre de 2026, en dólares por millón de tokens, según la página oficial de precios.
| Componente | Flare 2.6 | Sunburst 2.6 |
|---|---|---|
| Texto de entrada | USD 5 | USD 5 |
| Texto de entrada en caché | USD 1,25 | USD 1,25 |
| Imagen de entrada | USD 8 | USD 8 |
| Imagen de entrada en caché | USD 2 | USD 2 |
| Imagen de salida | USD 30 | USD 30 |
No son precios fijos por imagen. El total depende del consumo de la operación. Tampoco describen la suscripción de ChatGPT. Y la tarifa por token, incluso cuando coincide con la de otro modelo, no prueba que producir la misma pieza vaya a costar lo mismo.
Para decidir en producción, agregaría otra cuenta. Cuántos resultados se descartan, cuántas correcciones requiere el elegido y cuánto tiempo humano consume llegar al archivo aprobado. No hace falta una planilla sofisticada para comenzar: registra la tarea, los intentos, el consumo que devuelve la API y los minutos de revisión.
Esto permite discutir una elección con contexto. Un modelo puede justificar un mayor consumo si evita trabajo posterior; otro puede resultar más conveniente para explorar direcciones que todavía no necesitan detalle. Esas son hipótesis para medir con tareas comparables. Una tabla de tarifas no elige por ti.
Lo que falta comprobar antes de incorporarlo a una campaña
La documentación conserva límites sobre consistencia, texto y composiciones complejas. Además, la system card de Images 2.6 describe evaluaciones y mitigaciones de seguridad, incluidas las relacionadas con GIF. Esas evaluaciones sirven para entender el tratamiento del riesgo; no certifican la calidad creativa de una pieza ni reemplazan su revisión editorial.
Para una campaña, añadiría preguntas que la galería del lanzamiento no puede responder por nosotros. ¿El mismo personaje se sostiene en una serie? ¿La etiqueta conserva sus proporciones después de varias correcciones? ¿Una adaptación deja espacio para el texto que realmente debe llevar? ¿El equipo puede continuar una versión sin depender de quien la generó?
También conviene distinguir entre un error del modelo y una decisión que nunca se especificó. Si el equipo no definió cuánto puede cambiar un producto o qué rasgos identifican a un personaje, la revisión termina usando criterios que aparecen después del resultado. Eso vuelve difícil aprender de los intentos y comparar herramientas.
No daría por resuelta una comparación con otros generadores a partir de este anuncio. Para elegir entre modelos necesitamos el mismo encargo, referencias equivalentes y condiciones de evaluación claras. Los ejemplos destacados por un proveedor son un punto de partida para investigar, no una clasificación independiente.
Cómo probarlo con una tarea real
Para llevar esta evaluación a tu equipo, elige una tarea recurrente y acotada: una imagen de producto que necesite dos correcciones y una adaptación. Usa material autorizado y deja por escrito lo que debe permanecer. Empieza por entender el comportamiento del flujo antes de extenderlo a una tanda completa.
- Fija el punto de partida. Guarda referencias, formato, textos exactos y elementos que no pueden cambiar. Separa preferencias de condiciones obligatorias.
- Haz una comparación controlada. Entrega el mismo encargo a los modelos que quieras evaluar. Registra los parámetros y conserva también los resultados rechazados.
- Pide correcciones concretas. Cambia un elemento y después otro. Revisa si lo ya aprobado se conserva; no juzgues sólo la primera salida.
- Mira el archivo en su destino. Prueba la lectura en móvil, la edición del vector o la reproducción del loop según corresponda. Evalúa el uso real.
- Cierra la cuenta completa. Anota intentos, consumo, minutos de revisión y motivo de aceptación o descarte. Repite antes de convertir un resultado aislado en una regla.
Una prueba así deja algo que una tarde de exploración suele perder: razones para elegir. También hace visible qué parte del proceso necesita mejorar. Puede ser el modelo, una referencia insuficiente, un criterio de aprobación ambiguo o una etapa manual que sigue consumiendo demasiado tiempo.
Si quieres profundizar en esa organización del trabajo, en Creative Workflows desarrollamos cómo conectar decisiones creativas, herramientas y continuidad. Es una conversación especialmente pertinente cuando cada lanzamiento hace más fácil producir archivos y más necesario entender qué merece avanzar.
El micrófono se cierra
Images 2.6 abre posibilidades interesantes para iterar, dirigir correcciones y llevar una idea hacia otros formatos. La prueba más útil empieza cuando eliges una de esas posibilidades y la llevas a una tarea con condiciones reales.
Me quedaría con una escena sencilla: tienes una pieza que funciona y alguien pide cambiar un detalle. Si el siguiente resultado conserva lo que estaba bien y resuelve el pedido, el equipo avanza. Si obliga a comenzar de nuevo, habrá que entender dónde se perdió el control. Ahí se juega buena parte del valor de este lanzamiento.
Para seguir estas conversaciones, suscríbete a Glitch: cada lunes, IA, marketing y negocios con una lectura que ayude a decidir. Cuando una noticia no espera al lunes, abrimos el micrófono en modo Flash.
Nota editorial: artículo desarrollado con apoyo de agentes de IA en investigación, estructura, edición y pruebas visuales. Las demostraciones oficiales están atribuidas a sus fuentes. Las escenas de Nexa son ficción sintética producida por Efeonce con GPT Image 2.6 Sunburst; la sección de pruebas identifica sus condiciones y muestra las cuatro salidas del modelo sin retoque. La portada Glitch es una composición posterior identificada como tal. Fuentes y pruebas revisadas el 5 de noviembre de 2026.