 EL MAGAZINE SEMANAL


El 15 de septiembre de 2026, una startup llamada TypeSafe AI lanzó un modelo de IA que no escribe una sola palabra. Ni un correo, ni un resumen, ni un poema sobre tu marca. Le entregas un caso y una lista de preguntas con respuestas cerradas, y te devuelve una probabilidad por cada opción. Eso es todo.
Suena a retroceso, ¿no? Llevamos tres años pidiéndole a la IA que escriba más y mejor, y de pronto aparece una que se queda callada. Pero ocho semanas después, OpenAI, Google, Microsoft, Cloudflare, AWS y Databricks tenían su propia versión. La industria le puso nombre: Decisions API.
Mi lectura es que la noticia no está en el modelo. Está en que por primera vez existe una pieza de infraestructura hecha para la parte del trabajo que más se repite en ventas, marketing y servicio: decidir. A quién le toca este lead. Si este ticket se escala. Qué cuenta se atiende primero. Vamos por partes: qué son, por qué aparecieron ahora, qué ofrece cada proveedor y cómo se arma con ellas una capa de decisión que tu equipo pueda auditar.
Capítulo 01 · 1 min
¿Qué es una Decisions API?
Una Decisions API es un servicio que recibe un caso (un correo, un ticket, una ficha de CRM, una imagen) junto con una o más preguntas de respuesta cerrada, y devuelve una probabilidad por cada respuesta posible, sin generar texto. El modelo que la atiende se conoce como modelo de decisión; TypeSafe AI los llama «System One», un nombre que recuerda al pensamiento rápido e intuitivo que describió Daniel Kahneman.
Tal vez estás pensando que eso ya lo hace ChatGPT si se lo pides con cariño. Casi. La diferencia está en lo que te devuelve y en quién se queda con el trabajo después. Un modelo generativo te entrega un texto que tu sistema tiene que leer, validar y, cuando sale creativo, volver a pedir. Un modelo de decisión te entrega un dato tipado: una opción de tu lista y qué tan seguro está de ella.
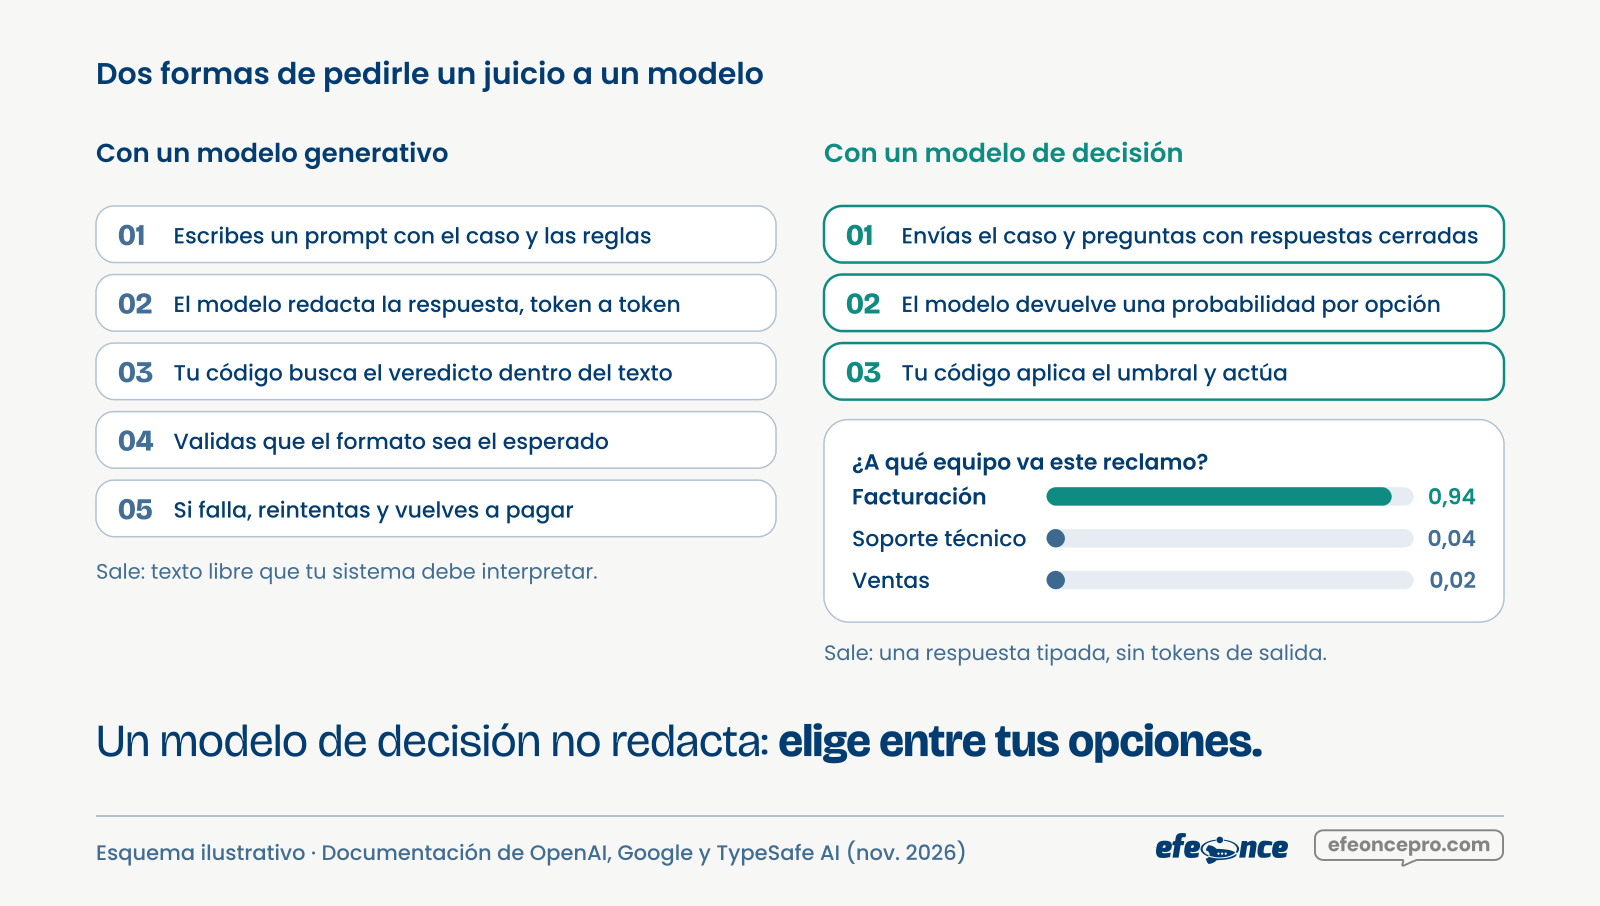
Los tres proveedores principales coinciden en los mismos tipos de pregunta, con nombres apenas distintos:
| Tipo | Qué pregunta | Qué devuelve | Ejemplo |
|---|---|---|---|
| Sí o no | Si una condición se cumple | Una probabilidad de 0 a 1 | ¿El producto llegó dañado? |
| Elegir | Cuál de tus opciones corresponde | La opción ganadora y la probabilidad de cada una | ¿A qué equipo va el caso? |
| Puntuar | En qué nivel de tu rúbrica cae | Un puntaje ponderado por probabilidad | ¿Qué tan grave es el problema? |
El modelo generativo te entrega un texto. El modelo de decisión te entrega un dato
Capítulo 02 · 2 min
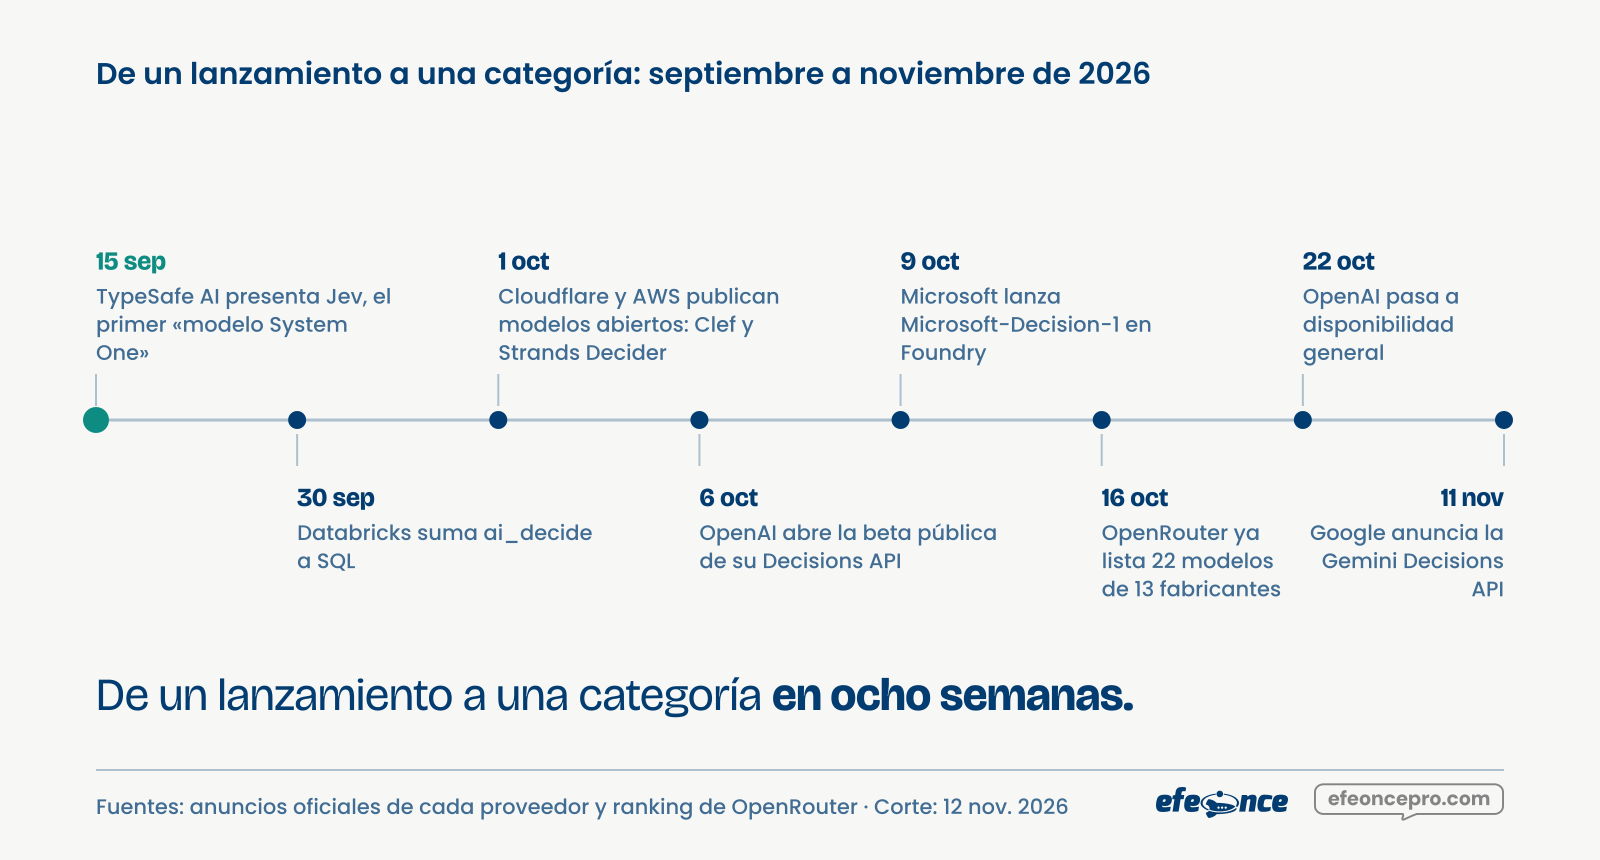
De Jev a Gemini: una categoría en ocho semanas
Pocas categorías de software se han formado tan rápido. TypeSafe AI abrió el camino con Jev en acceso anticipado. En las tres semanas siguientes Databricks lo llevó a SQL con la función ai_decide, Cloudflare y AWS publicaron modelos abiertos, OpenAI abrió su beta y Microsoft lanzó Microsoft-Decision-1. El 11 de noviembre Google sumó la Gemini Decisions API. Ocho semanas: hay comités que tardan más en aprobar un logo.
Qué ofrece cada proveedor
Los cuatro que hoy marcan la categoría se parecen en el contrato y se diferencian en el alcance. Esto es lo que cada uno publica en su documentación:
| Proveedor | Modelo | Qué recibe | Tope por llamada | Estado |
|---|---|---|---|---|
| TypeSafe AI | Jev 1.14 | Texto, JSON e imagen | Varias preguntas (sin tope publicado) | Acceso anticipado; abierto en OpenRouter |
| OpenAI | GPT-6 Luna | Texto, imágenes y JSON | 400 preguntas | Disponibilidad general desde el 22 de octubre |
| Gemini Decision 1 | Texto, imagen, audio, video y PDF | 1.000 preguntas | Lanzada el 11 de noviembre; endpoint v1beta | |
| Microsoft | Microsoft-Decision-1 | Texto | No publicado | Disponible en Foundry y OpenRouter |
El precio confirma para qué están pensadas. Todas cobran sólo los tokens de entrada, porque no hay texto de salida que cobrar, y lo hacen a centavos de dólar por millón.
En uso real, el que abrió la categoría sigue adelante. En la semana del 2 de noviembre, el ranking de OpenRouter le atribuía a TypeSafe AI cerca de siete de cada diez solicitudes de decisión que pasan por su plataforma. Es una sola plataforma de ruteo y no mide el tráfico directo a OpenAI o Google, pero muestra que el estándar lo fijó quien llegó primero: Cloudflare y Databricks declaran compatibilidad con su formato.
Ver los datos
| Dato | Participación | Participación |
|---|---|---|
| TypeSafe AI | 71,1 % | 71,1 % |
| Perplexity | 11 % | 11 % |
| Nace.AI | 5 % | 5 % |
| Otros | 12,9 % | 12,9 % |
Capítulo 03 · 2 min
¿Por qué aparecen ahora?
Porque los agentes de IA tropiezan justo donde menos se nota: en el juicio. Un agente que atiende un caso de ventas o de servicio no hace una gran tarea; encadena decenas de decisiones chicas. ¿Esto es una queja o una consulta? ¿Sigo, reintento o pido una aclaración? ¿Uso esta herramienta o aquella?
Hoy resolvemos cada una de esas mini decisiones con el modelo más grande y más caro que tenemos. Es como llamar a un cirujano para poner una curita: funciona, pero en algún momento alguien pregunta por la cuenta. Y además de lento y caro, es frágil.
La evidencia de esa fragilidad viene del propio mundo del CRM. CRMArena-Pro, el benchmark de Salesforce AI Research con 19 tareas de ventas, servicio y cotización, encontró que los mejores agentes resuelven bien cerca del 58 % de las tareas de un solo turno y cerca del 35 % cuando la tarea exige varios.
Ver los datos
| Dato | Tareas resueltas |
|---|---|
| Tareas de un turno | 58 % |
| Tareas de varios turnos | 35 % |
El resultado se nota en los presupuestos. Gartner proyecta que más del 40 % de los proyectos de IA agéntica se cancelará antes de fines de 2027 por costos, valor poco claro o controles de riesgo insuficientes. Y según McKinsey, el 62 % de las organizaciones ya experimenta con agentes, pero sólo el 23 % los está escalando.
Ver los datos
| Dato | Proyectos |
|---|---|
| proyectos de agentes se cancelaría antes de fines de 2027 | 40 |
Fuente: Gartner, junio de 2025
Los modelos de decisión atacan ese punto exacto. OpenAI lo dice sin rodeos en su anuncio: por separado esas decisiones son sencillas, pero a gran escala su latencia y su costo se acumulan. Sacarlas del modelo grande y dárselas a uno especializado deja al modelo generativo haciendo lo que hace bien, que es planificar y redactar.
Lo que reportan los primeros clientes
El anuncio de disponibilidad general de OpenAI trae cinco testimonios con cifras. Los resumimos tal como cada empresa los reporta: son mediciones propias, cada una contra su enfoque anterior, y no son comparables entre sí.
- Sierra (agentes de atención al cliente): elige la siguiente acción durante conversaciones en vivo unas 3 veces más rápido y con un costo por llamada 90 % menor.
- Datadog: puntúa el riesgo de comandos generados por agentes antes de ejecutarlos, 40 veces más rápido en el percentil 95.
- Box: clasifica documentos y los dirige al siguiente paso unas 5 veces más rápido, y deriva a revisión humana los casos de menor confianza.
- Ramp: atribuye sus costos de IA 4 veces más rápido y con 30 % menos de costo.
- Speak (aprendizaje de idiomas): bajó el tiempo hasta la siguiente acción de 1,4 a 0,13 segundos en una experiencia de voz.
Su latencia p95 es inferior a 280 ms.
Ajeet Grewal, ingeniero de Sierra, en el anuncio de OpenAI
El caso de Sierra es el que más le importa a un equipo de servicio: 280 milisegundos es menos de lo que una persona tarda en notar una pausa en una conversación. Ahí la decisión deja de ser un paso que se espera y pasa a ser parte del diálogo.
Capítulo 04 · 1 min
Cómo se ve una llamada
Si esperabas algo intimidante, lamento decepcionarte: el contrato es más simple que el de cualquier API de chat. Este es el ejemplo de la documentación de Google: un reclamo de un cliente y una pregunta de sí o no.
curl -X POST "https://generativelanguage.googleapis.com/v1beta/decisions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" -H "Content-Type: application/json" \
  -d '{"model":"gemini-decision-1",
       "input":"The blue mug I ordered on Monday arrived cracked on Wednesday.",
       "questions":{"is_damaged":{"type":"noul","instructions":"Did the item arrive damaged?"}}}'
Y esta es la respuesta. No hay texto que interpretar: una probabilidad, un nivel de confianza y el consumo.
{"answers":{"is_damaged":{"type":"noul","noul":0.99,"confidence":0.99}},
 "usage":{"total_input_tokens":100,"total_output_tokens":0,"total_tokens":100}}
La llamada de OpenAI tiene la misma forma: un insumo, una lista de preguntas con nombre, tipo e instrucciones, y una lista de respuestas. Ese parecido importa. Si el contrato es casi el mismo entre proveedores, cambiar de uno a otro cuesta poco, y eso te deja elegir por precio, latencia o residencia de datos. No publicamos aquí una prueba propia: los ejemplos son los de la documentación oficial y no los corrimos contra tráfico real.
Capítulo 05 · 2 min
Dónde vive la decisión en un stack go-to-market
Hasta acá, todo bien. Pero ojo: un modelo de decisión por sí solo no cambia nada. Lo que cambia la operación es la capa que se arma a su alrededor.
Vamos con manzanitas 🍏🍏🍏: piensa en quien recibe a los pacientes en una clínica. Escucha lo que le cuentan, se hace dos o tres preguntas rápidas (¿es urgente?, ¿a qué especialidad va?), aplica una regla que no inventó (lo urgente pasa primero) y lo anota en la ficha. Nadie le pide que redacte un informe. Le piden que decida bien, rápido y que quede registro. Eso mismo, en tu operación comercial, son cuatro piezas: señales, preguntas cerradas, umbral y registro.
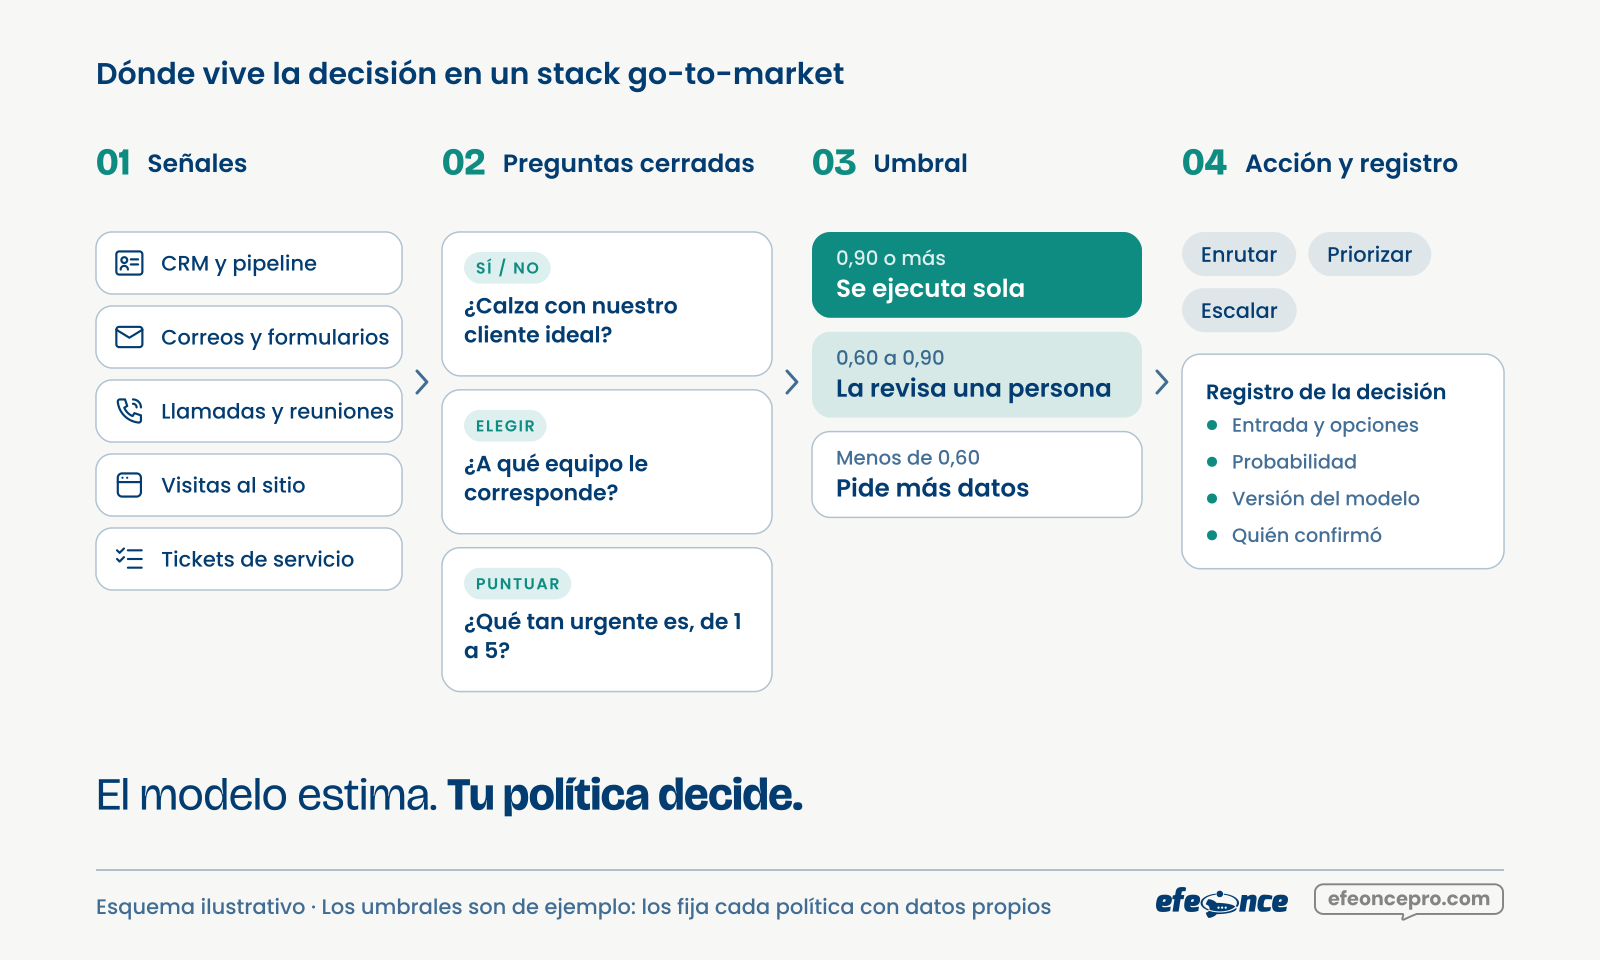
- Señales. Lo que ya existe en tu CRM, tu bandeja de servicio, tus formularios y tus llamadas. Si el dato está sucio o repartido, la decisión hereda el desorden.
- Preguntas cerradas. Cada decisión del equipo escrita como una pregunta con respuestas definidas. Este es el trabajo de diseño que más pesa, y es de negocio, no de ingeniería.
- Umbral. La regla que convierte una probabilidad en una acción: qué se ejecuta solo, qué revisa una persona y qué se devuelve por falta de información.
- Acción y registro. El sistema ejecuta y guarda qué entró, qué opciones había, qué probabilidad salió, con qué versión del modelo y quién confirmó.
La cuarta pieza es la que separa un experimento de una infraestructura. Sin registro no puedes calibrar los umbrales, no puedes explicar una decisión cuando un cliente la reclama y no puedes cambiar de proveedor sin empezar de cero. Es el mismo principio que aplicamos cuando diseñamos el agente de atención de ANAM: la IA propone dentro de un marco que el negocio definió y que alguien puede revisar.
El modelo estima. Tu política decide
Capítulo 06 · 7 min
Seis casos de uso para ventas, marketing y servicio
Aquí viene la parte incómoda: ningún proveedor ha publicado todavía un caso de ventas o de marketing. Sus ejemplos oficiales son todos de servicio. Así que en Efeonce armamos seis casos propios, pensados para que una empresa con un CRM ordenado los pueda poner en producción. Cada uno trae el disparador, las preguntas exactas, la acción, el punto donde entra una persona y qué medir. Los valores de las fichas son de ejemplo; el diseño es el que usaríamos.
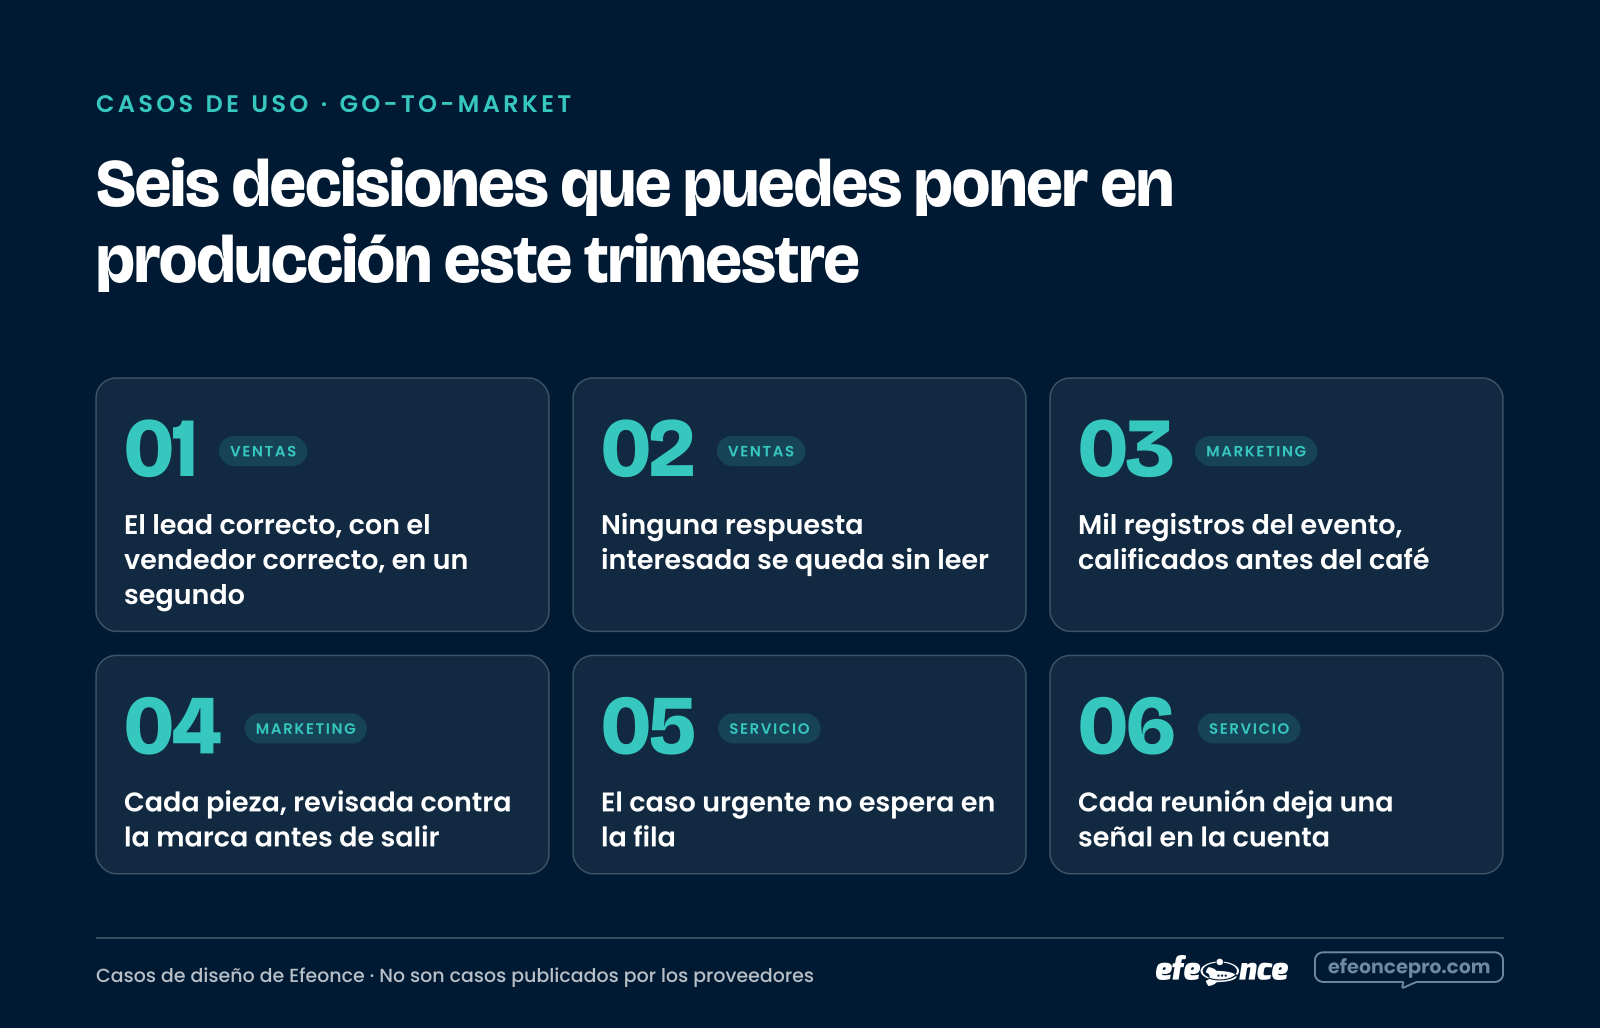
Así se ve el primero en movimiento: el lead entra, se responden tres preguntas y la acción queda hecha en el CRM.
Caso 01: el lead correcto, con el vendedor correcto, en un segundo
Piensa en el último lead que pidió una demo un viernes a las seis de la tarde. ¿Quién lo vio primero: tu vendedor o tu competencia? Un lead pierde valor con cada hora que nadie lo toma. Aquí la decisión ocurre en el mismo instante en que se envía el formulario, con los datos que ya tienes: lo que la persona escribió y lo que tu CRM sabe de la empresa.
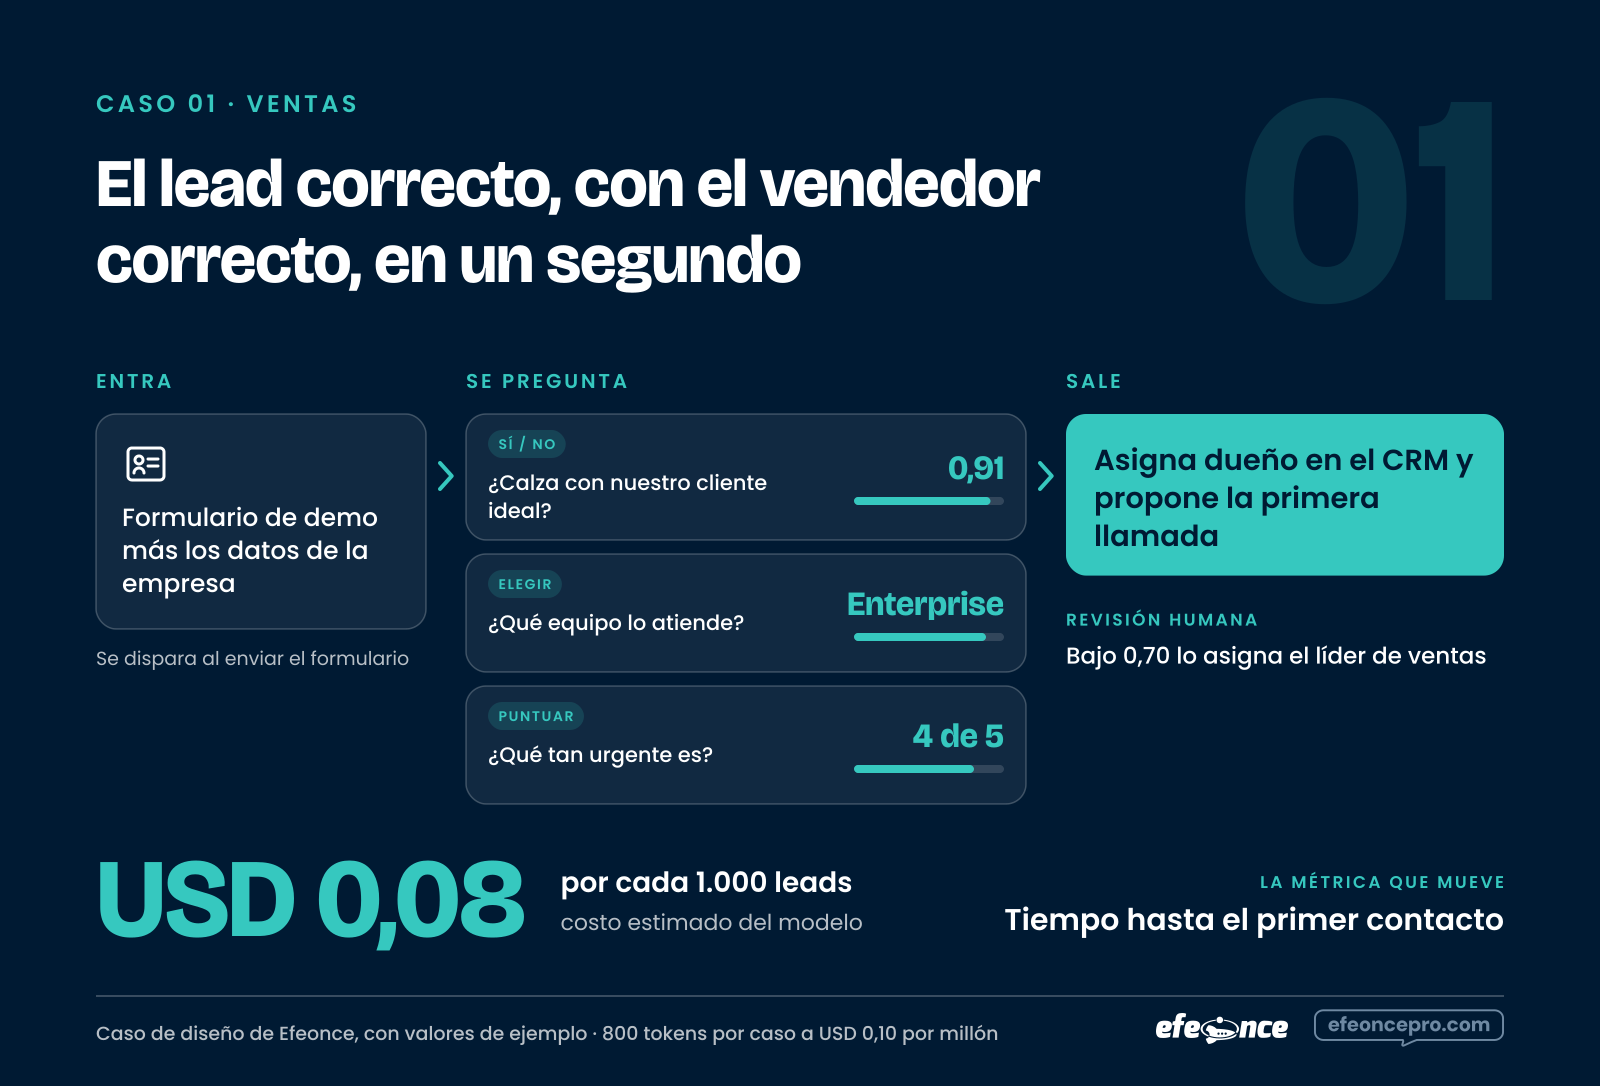
- Disparador: se dispara al enviar el formulario.
- Preguntas: ¿Calza con nuestro cliente ideal? (sí / no). ¿Qué equipo lo atiende? (elegir). ¿Qué tan urgente es? (puntuar).
- Acción: asigna dueño en el CRM y propone la primera llamada.
- Revisión humana: bajo 0,70 lo asigna el líder de ventas.
- Qué medir: tiempo hasta el primer contacto.
Mide el tiempo hasta el primer contacto antes y después. Si el equipo reasigna más de uno de cada diez leads, las opciones de «equipo» están mal definidas.
Caso 02: ninguna respuesta interesada se queda sin leer
Una campaña de prospección genera respuestas de todo tipo: interés real, objeciones, avisos de vacaciones y pedidos de baja. Todas caen en la misma bandeja, y la que dice «me interesa, ¿hablamos el martes?» espera su turno detrás de doce «estaré fuera de la oficina». Tres preguntas las separan.
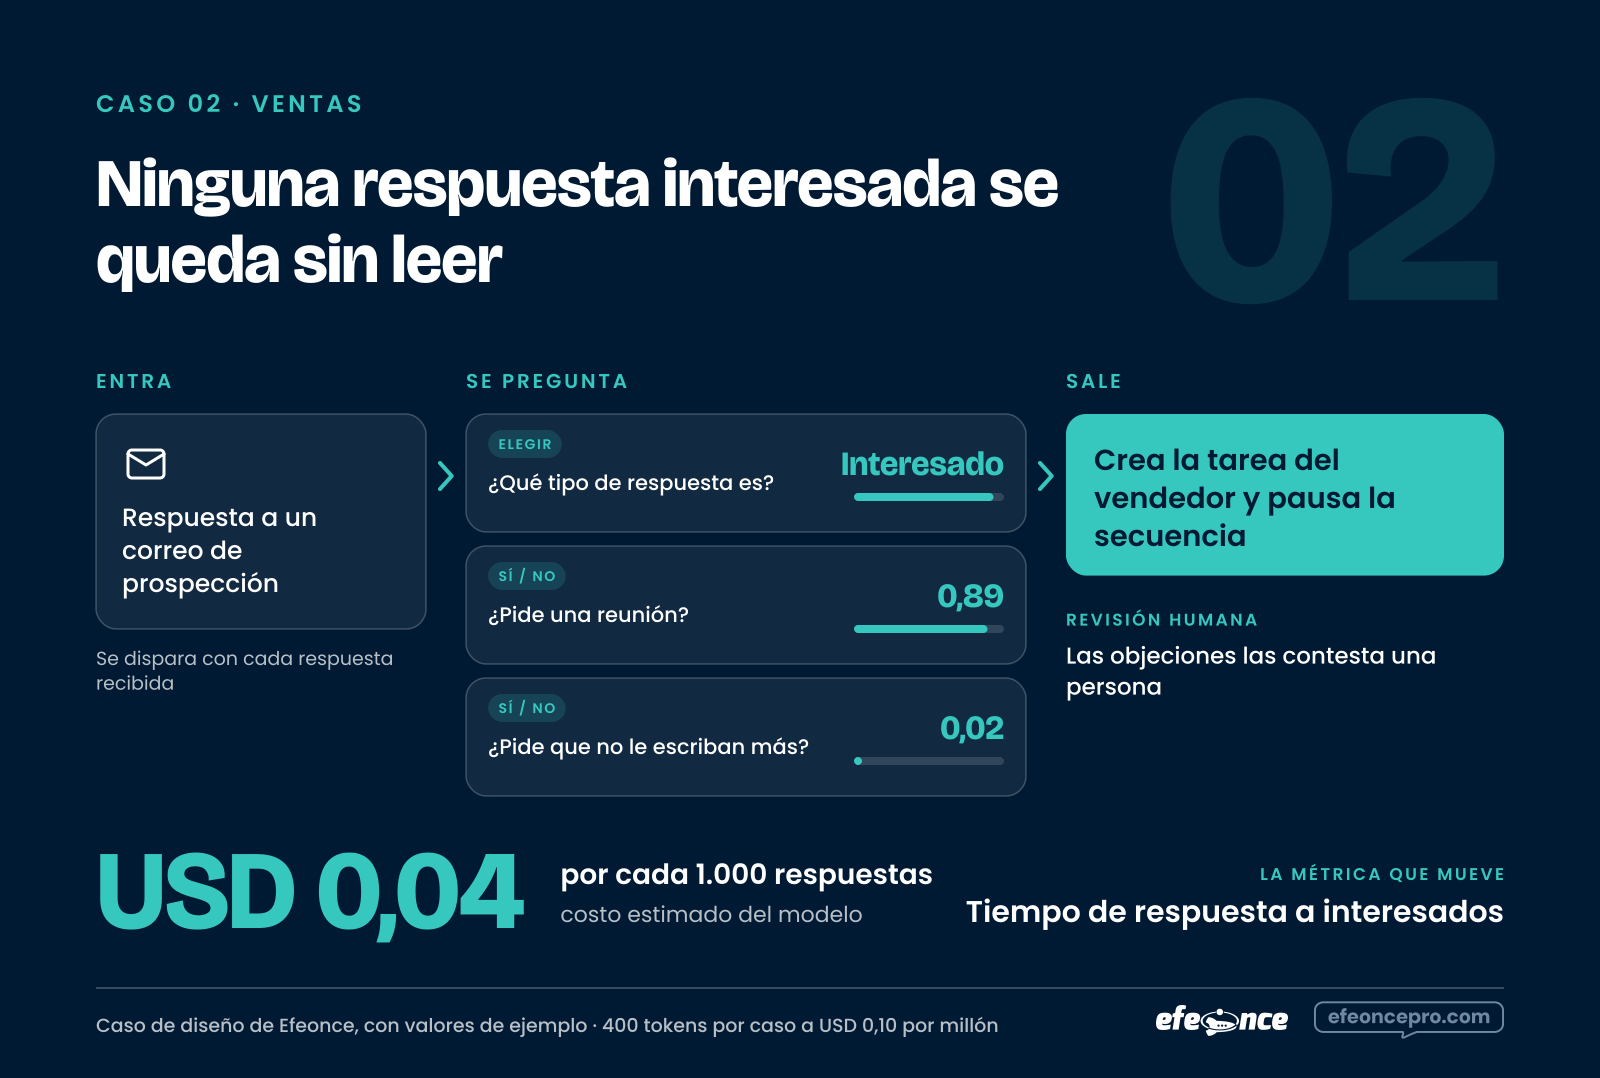
- Disparador: se dispara con cada respuesta recibida.
- Preguntas: ¿Qué tipo de respuesta es? (elegir). ¿Pide una reunión? (sí / no). ¿Pide que no le escriban más? (sí / no).
- Acción: crea la tarea del vendedor y pausa la secuencia.
- Revisión humana: las objeciones las contesta una persona.
- Qué medir: tiempo de respuesta a interesados.
El pedido de baja se ejecuta siempre, con cualquier probabilidad sobre 0,50: es una obligación, no una optimización. Lo que mides es cuánto tarda en responderse un «interesado».
Caso 03: mil registros del evento, calificados antes del café
Después de un evento llega la planilla. Mil registros, a veces más. Y entonces pasa una de dos cosas: ventas recibe la lista completa y la ignora con elegancia, o alguien la filtra a mano durante días. Un modelo de decisión evalúa cada registro contra los criterios de tu cliente ideal en una sola pasada.
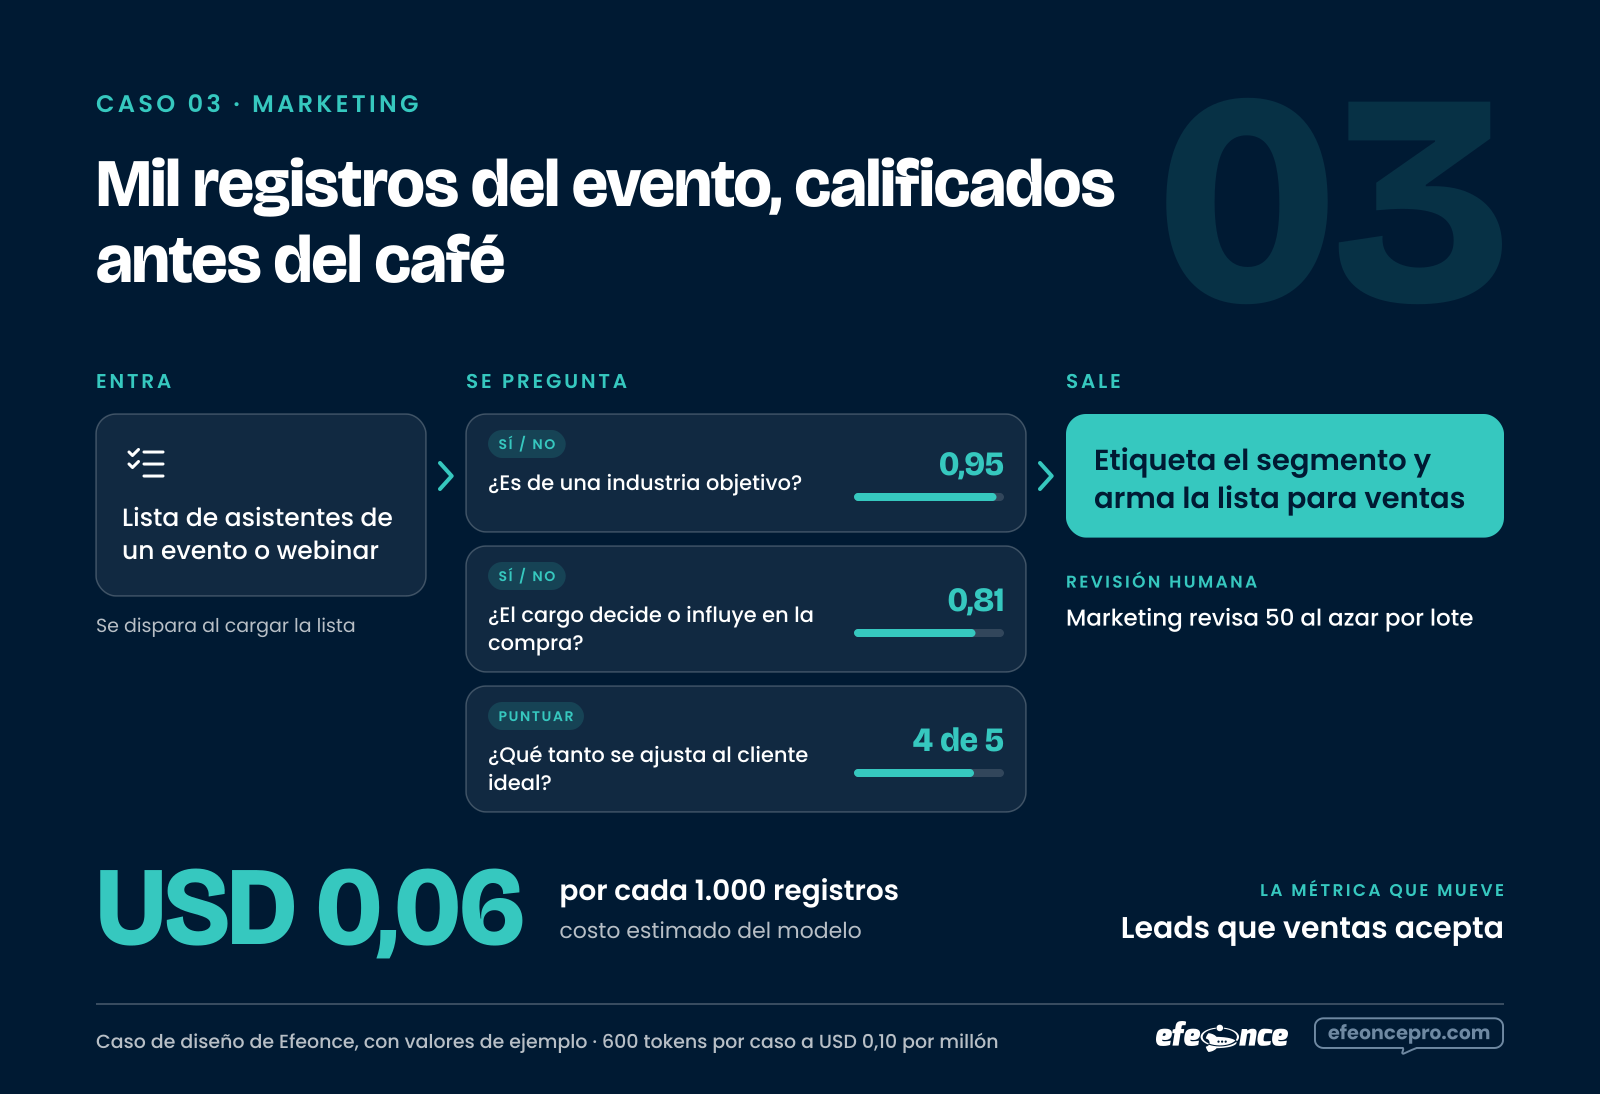
- Disparador: se dispara al cargar la lista.
- Preguntas: ¿Es de una industria objetivo? (sí / no). ¿El cargo decide o influye en la compra? (sí / no). ¿Qué tanto se ajusta al cliente ideal? (puntuar).
- Acción: etiqueta el segmento y arma la lista para ventas.
- Revisión humana: marketing revisa 50 al azar por lote.
- Qué medir: leads que ventas acepta.
El muestreo de 50 registros por lote es lo que mantiene honesto al sistema: si marketing discrepa en más de cinco, se ajustan las instrucciones antes del próximo evento.
Caso 04: cada pieza, revisada contra la marca antes de salir
Cuando el volumen de piezas crece, la revisión de marca se vuelve el cuello de botella o, seamos francos, deja de hacerse. Este caso no escribe ni corrige: sólo responde si la pieza cumple, para que quien revisa llegue directo a las que tienen un problema.
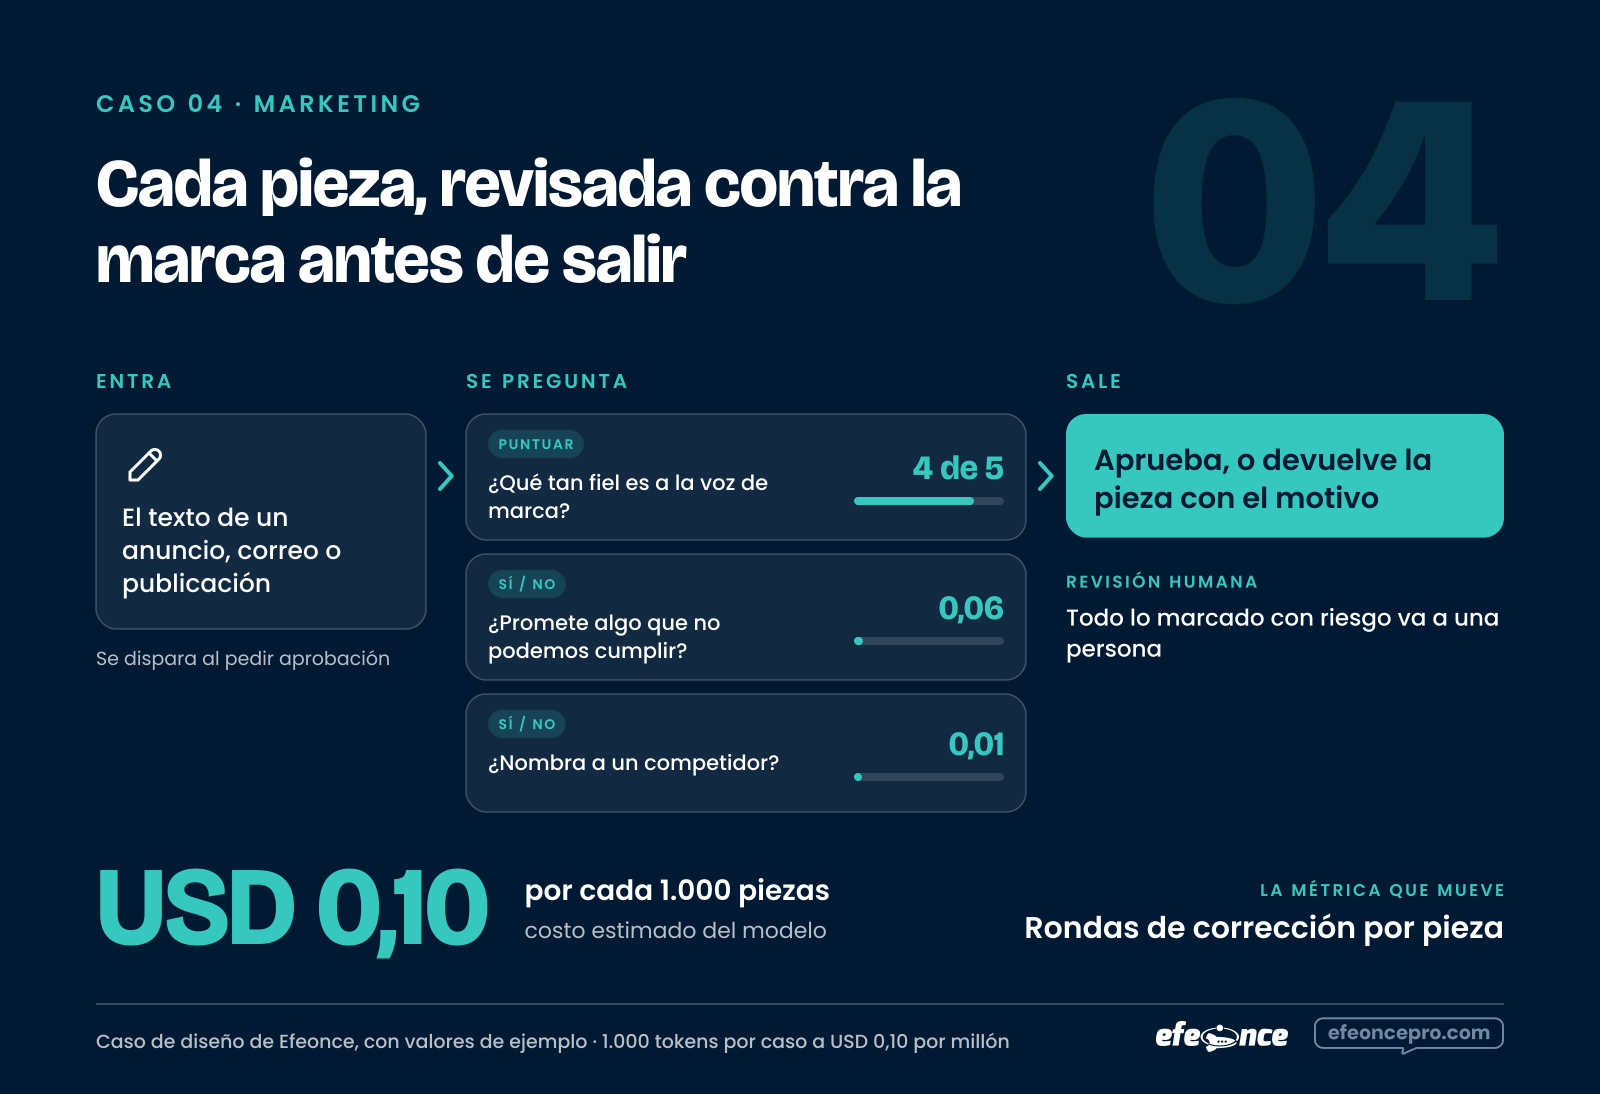
- Disparador: se dispara al pedir aprobación.
- Preguntas: ¿Qué tan fiel es a la voz de marca? (puntuar). ¿Promete algo que no podemos cumplir? (sí / no). ¿Nombra a un competidor? (sí / no).
- Acción: aprueba, o devuelve la pieza con el motivo.
- Revisión humana: todo lo marcado con riesgo va a una persona.
- Qué medir: rondas de corrección por pieza.
Requiere que tu guía de voz exista por escrito y con ejemplos; la rúbrica de «fidelidad a la voz» sale de ahí. Sin esa guía, el puntaje no significa nada.
Caso 05: el caso urgente no espera en la fila
En una cola de servicio el orden de llegada rara vez coincide con el orden de importancia: el cliente que está a punto de irse espera detrás del que olvidó su contraseña. Clasificar equipo, gravedad y riesgo en el momento en que entra el caso permite que lo urgente salte la fila y que el ejecutivo de cuenta se entere a tiempo.
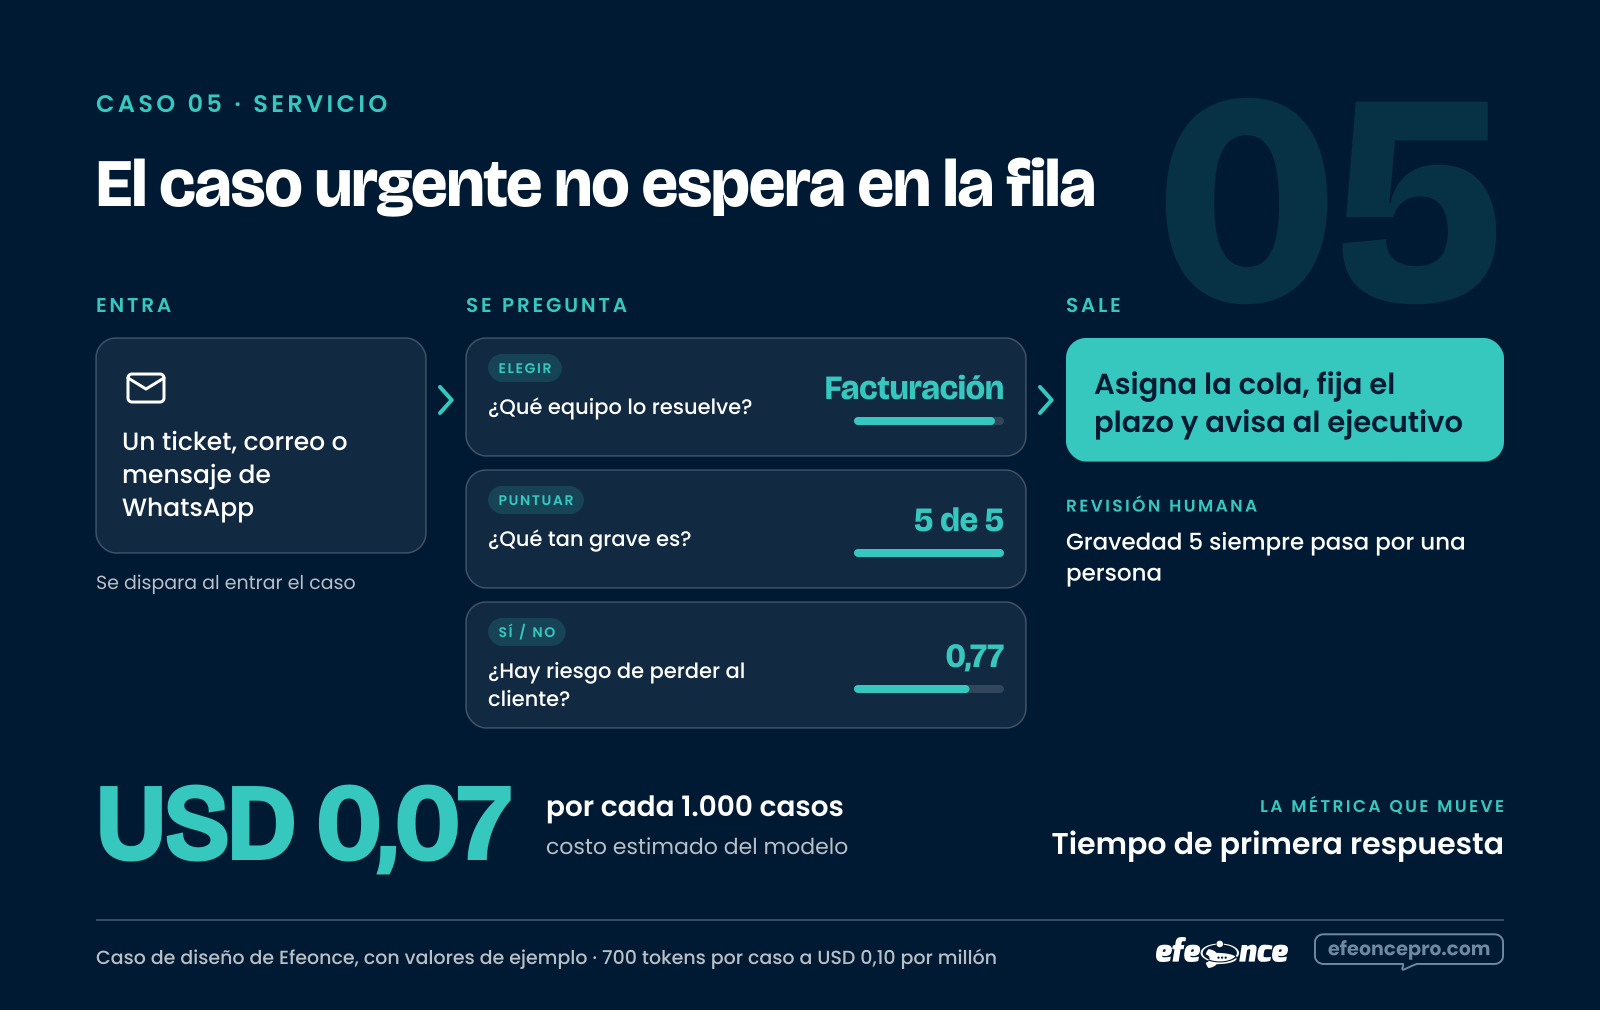
- Disparador: se dispara al entrar el caso.
- Preguntas: ¿Qué equipo lo resuelve? (elegir). ¿Qué tan grave es? (puntuar). ¿Hay riesgo de perder al cliente? (sí / no).
- Acción: asigna la cola, fija el plazo y avisa al ejecutivo.
- Revisión humana: gravedad 5 siempre pasa por una persona.
- Qué medir: tiempo de primera respuesta.
La gravedad máxima nunca se resuelve sola: el modelo la detecta y la acelera, pero la respuesta la da una persona. Mide el tiempo de primera respuesta por nivel de gravedad, no el promedio.
Caso 06: cada reunión deja una señal en la cuenta
¿Cuántas veces un cliente mencionó a un competidor en una reunión y eso nunca llegó al CRM? Las reuniones están llenas de señales que se quedan en la memoria de quien estuvo ahí: una funcionalidad que falta, una oportunidad de ampliar. Con la transcripción como insumo, cada reunión deja tres datos estructurados en la cuenta.
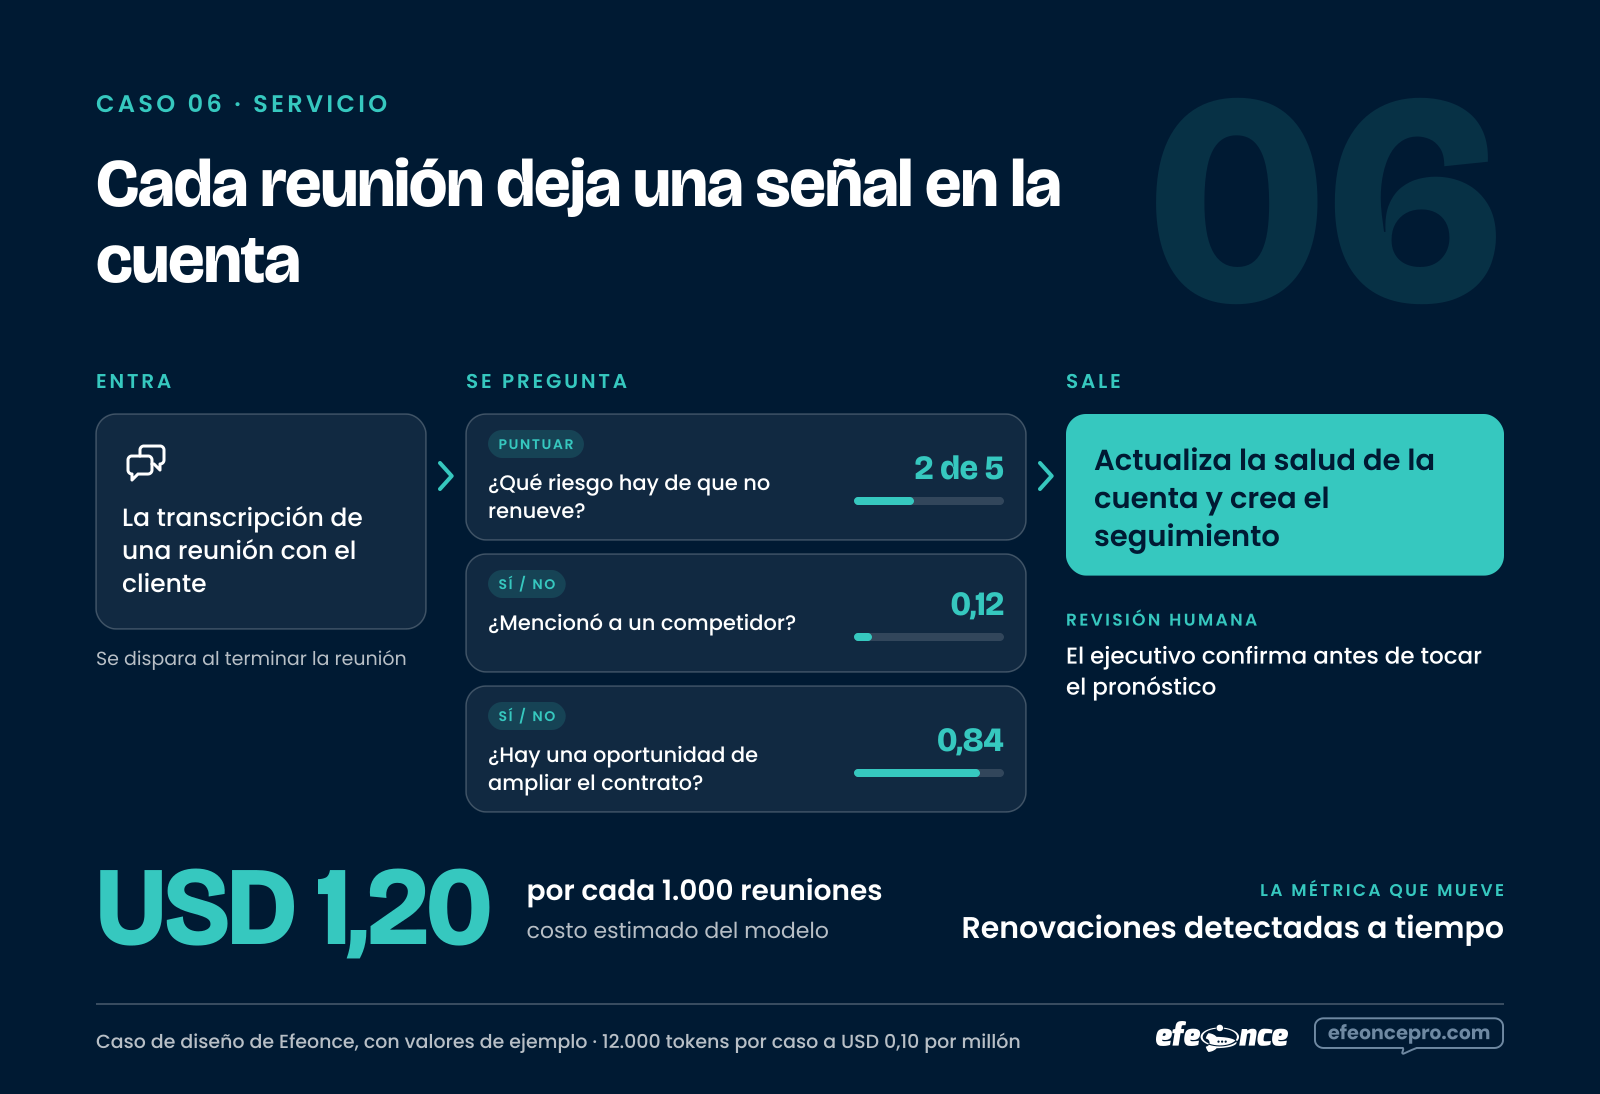
- Disparador: se dispara al terminar la reunión.
- Preguntas: ¿Qué riesgo hay de que no renueve? (puntuar). ¿Mencionó a un competidor? (sí / no). ¿Hay una oportunidad de ampliar el contrato? (sí / no).
- Acción: actualiza la salud de la cuenta y crea el seguimiento.
- Revisión humana: el ejecutivo confirma antes de tocar el pronóstico.
- Qué medir: renovaciones detectadas a tiempo.
Es el caso más caro por unidad, porque una transcripción tiene miles de tokens, y aun así cuesta poco más de un dólar por cada mil reuniones. Necesita el consentimiento de grabación que ya exige tu política de privacidad.
Cuánto cuesta decidir
Si llegaste hasta acá esperando la letra chica del precio, aquí está, y es menos dramática de lo que crees. El costo del modelo es casi irrelevante frente al del trabajo que ordena. Con el precio de lista de OpenAI y de Google, mil decisiones cuestan entre 4 centavos y poco más de un dólar según cuánto texto lleve cada caso. Lo que sí cuesta es el diseño de las preguntas, la integración con el CRM y el tiempo de quienes revisan.
Capítulo 07 · 1 min
No es next-best-action ni un motor de reglas
Si llevas años en marketing, esto te va a sonar conocido, y con razón: «decisioning» existe hace décadas. Conviene separar cuatro cosas que comparten palabra:
| Qué es | Qué decide | Cómo decide | Ejemplos |
|---|---|---|---|
| Modelo de decisión | Cualquier pregunta cerrada sobre un caso | Un modelo de lenguaje que devuelve probabilidades | Jev, Decisions API, Gemini Decisions API |
| Next-best-action | Qué oferta, canal y momento para cada cliente | Modelos entrenados con el historial de tus clientes | Pega, Adobe, Braze |
| Motor de reglas y riesgo | Aprobar un crédito, detectar fraude | Reglas explícitas más modelos auditables | FICO, Taktile |
| Política para agentes | Si un agente puede ejecutar una acción | Reglas de permiso, sin modelo | AWS AgentCore Policy, Cerbos |
No se reemplazan. El next-best-action aprende de tus datos y por eso gana cuando hay mucho historial: Commonwealth Bank declara más de 20 millones de decisiones al día con ese enfoque. El modelo de decisión no necesita historial: entiende lenguaje y funciona desde el primer día con una pregunta bien escrita. El diseño sensato usa los dos, y deja las reglas duras (un descuento máximo, un cliente bloqueado) en código, antes y después del modelo.
Capítulo 08 · 4 min
Límites y riesgos que conviene mirar antes
- Formato garantizado no es respuesta correcta. El modelo siempre devuelve una opción válida de tu lista. Puede ser la equivocada, y con probabilidad alta.
- La calibración se prueba con tus datos. Usuarios del foro de OpenAI reportaron que el orden de las opciones movía las probabilidades. Un umbral sólo vale si lo mediste con casos tuyos ya etiquetados.
- Las preguntas no se ven entre sí. Si una decisión depende de otra, esa dependencia la resuelve tu código.
- Una probabilidad no es una explicación. Si necesitas justificar la decisión ante un cliente, el registro y la política hacen ese trabajo; el número solo, no.
- La categoría tiene dos meses. Precios, límites y nombres van a cambiar. Diseña la capa para poder cambiar de proveedor.
Qué exige la regulación en cada mercado
El riesgo que más pesa es legal, y cambia según dónde estén tus clientes, no según dónde esté tu empresa. No existe una regla única para América Latina y Estados Unidos, pero el patrón se repite: cuando una decisión automatizada afecta de forma importante a una persona, hay que avisar, explicar y ofrecer revisión humana.
| Mercado | Qué pide | Estado a noviembre de 2026 |
|---|---|---|
| Estados Unidos | No hay ley federal general. California exige aviso previo, exclusión voluntaria y acceso cuando un sistema automatizado toma una decisión significativa (crédito, vivienda, educación, empleo, salud). Colorado suma explicación, revisión humana y registros. | California: reglamento vigente desde enero de 2026, con cumplimiento de esta parte desde enero de 2027. Colorado: ley SB 26-189, firmada en mayo de 2026. |
| Unión Europea | Derecho a no quedar sujeto a decisiones basadas únicamente en tratamiento automatizado con efectos jurídicos o similares, con intervención humana y derecho a impugnar. | RGPD vigente. Las obligaciones de alto riesgo de la ley de IA se aplican desde diciembre de 2027. |
| Brasil | Derecho a pedir la revisión de decisiones tomadas únicamente por tratamiento automatizado, incluido el perfilamiento, y a conocer los criterios. | LGPD vigente. El marco legal de IA sigue en trámite en la Cámara. |
| México | Derecho a oponerse al tratamiento automatizado sin intervención humana que afecte de forma significativa los derechos o intereses de la persona. | Nueva ley federal de protección de datos, vigente desde marzo de 2025. |
| Chile | Derecho a oponerse a decisiones basadas en tratamiento automatizado con efectos significativos, con explicación y revisión humana. | Ley 21.719: vigencia fijada para diciembre de 2026, con una postergación a 2027 en trámite en el Congreso. |
| Colombia, Perú y Argentina | Colombia y Argentina aplican sus leyes generales de datos, sin regla específica. Perú tiene ley de IA con reglamento. | Colombia y Argentina: proyectos en trámite. Perú: reglamento vigente desde enero de 2026, con plazos escalonados. |
Hay un matiz que ordena el mapa. En Estados Unidos las reglas se activan por decisiones «significativas», como crédito, empleo o vivienda: enrutar un lead o clasificar un ticket normalmente queda fuera. En la Unión Europea, Brasil, México y Chile el criterio es más amplio, y negar un reembolso o fijar un precio personalizado sí puede entrar. En Europa, además, el Tribunal de Justicia resolvió en el caso SCHUFA que un puntaje puede ser por sí mismo una decisión automatizada cuando un tercero se apoya de forma determinante en él. Y la responsabilidad nunca se delega en el modelo: en Moffatt contra Air Canada, la aerolínea respondió por lo que su chatbot le dijo a un cliente.
Sí, son ocho jurisdicciones. No, no hay atajo. Pero hay una buena noticia: cuatro prácticas cumplen con casi todas estas normas a la vez, y son las mismas que hacen confiable al sistema:
- Avisa. Di que interviene un sistema automatizado y para qué.
- Ofrece revisión humana. Para toda decisión adversa o importante, con una persona que pueda revertirla.
- Explica y deja reclamar. Los criterios principales, los datos usados y un canal para corregir.
- Registra y evalúa. Guarda la entrada, la versión del modelo y el resultado, y revisa sesgos antes de desplegar.
Una regla práctica: automatiza primero las decisiones reversibles y de bajo impacto (enrutar, priorizar, etiquetar) y deja con revisión humana las que niegan algo a una persona (un reembolso, un crédito, un descuento).
Capítulo 09 · 1 min
Por dónde empezar
- Elige una sola decisión. Que se tome muchas veces al día, que hoy tome una persona y que sea reversible. El enrutamiento de leads o de tickets suele ser la mejor candidata.
- Escríbela como pregunta cerrada. Define las opciones y agrega siempre una salida («otro» o «no se puede determinar»). Si el equipo no se pone de acuerdo en las opciones, el problema era de proceso y lo encontraste gratis.
- Junta casos ya resueltos. Unos cientos de ejemplos reales con la respuesta que dio tu equipo. Son tu vara de medir.
- Corre en paralelo. Deja que el modelo decida sin ejecutar, compara con lo que hizo el equipo y fija los umbrales con esa evidencia.
- Registra todo desde el primer día. Entrada, opciones, probabilidad, versión y quién confirmó. Ese registro es tu defensa y tu material de mejora.
- Amplía de a una. Cuando la primera decisión esté estable, suma la siguiente. La capa crece por decisiones, no por proyectos.
Si tu sitio y tu CRM ya están pensados para que un agente los opere, este paso es corto. Si no, conviene partir por ahí: en cómo preparar tu sitio para los agentes de IA explicamos qué significa exponer capacidades con reglas y permisos compartidos.
Durante tres años medimos a la IA por lo bien que escribe. Lo que viene se va a medir por lo bien que decide. Y por si alguien en tu equipo puede explicar por qué decidió así.
Capítulo 10 · 2 min
Preguntas frecuentes
¿Qué es una Decisions API?
Es un servicio de IA que recibe un caso y una o más preguntas de respuesta cerrada, y devuelve una probabilidad por cada respuesta posible en lugar de generar texto. Sirve para clasificar, enrutar, priorizar y evaluar con baja latencia y bajo costo.
¿En qué se diferencia de pedirle lo mismo a ChatGPT o a un modelo generativo?
Un modelo generativo redacta una respuesta que tu sistema debe interpretar y validar. Un modelo de decisión elige entre opciones que tú definiste y entrega la probabilidad de cada una, sin tokens de salida. Por eso es más rápido, más barato y más fácil de auditar.
¿Qué es Jev?
Jev es el modelo de decisión de TypeSafe AI, presentado el 15 de septiembre de 2026. Fue el primero de la categoría y su formato de llamada se volvió la referencia: otros proveedores declaran compatibilidad con él.
¿Cuánto cuesta usar una Decisions API?
A noviembre de 2026, entre USD 0,042 y USD 0,10 por millón de tokens de entrada según el proveedor. Ninguna cobra tokens de salida. El costo real depende de cuánto contexto envías en cada llamada.
¿Reemplaza a un agente de IA?
No. Es una pieza dentro del agente o del flujo: resuelve los juicios entre pasos. El agente o tu aplicación siguen planificando, redactando y ejecutando la acción.
¿Puedo dejar que decida sola sobre reembolsos o descuentos?
Conviene que no, al menos al principio. Las decisiones que niegan algo a una persona deben tener revisión humana y, según la jurisdicción, pueden estar reguladas como decisiones automatizadas. Parte por las reversibles: enrutar, priorizar y etiquetar.
¿Sirve si mi equipo usa HubSpot o Salesforce?
Sí. La Decisions API no reemplaza al CRM: lee sus datos y escribe de vuelta el resultado, por ejemplo el equipo asignado o la prioridad. Lo que necesitas es que el dato esté ordenado y que la acción quede registrada.
Capítulo 11 · 1 min
Fuentes y nota de actualización
Este artículo se escribió con información vigente al 12 de noviembre de 2026. La categoría cambia cada semana: precios, límites y disponibilidad pueden haber variado. Las cifras de clientes son las que cada empresa reportó en el anuncio de OpenAI; las de Gartner son proyecciones.
- OpenAI: Crea aplicaciones más ágiles con la API Decisions y guía para desarrolladores
- Google: Gemini Decisions API y documentación
- TypeSafe AI: Introducing System One models and Jev
- Microsoft: Microsoft-Decision-1 en Foundry
- Cloudflare: Clef, AWS Strands Decider y Databricks ai_decide
- OpenRouter: ranking de modelos de decisión
- Salesforce AI Research: CRMArena-Pro
- Gartner: proyección sobre proyectos de IA agéntica y McKinsey: The State of AI
Cada semana contamos en Glitch qué cambió en IA, marketing y negocios, y qué hacer con eso. Suscríbete a Glitch. Y si quieres revisar qué decisiones de tu operación comercial vale la pena automatizar primero, agenda una conversación con nuestro equipo.